
Die häufigste Beschwerde über KI-generierte Animation ist, dass sie „nach KI aussieht". Meist meint die Person damit, dass etwas Bestimmtes technisch falsch ist – ein Gesicht verformt sich leicht zwischen den Frames, ein Logo flackert an den Rändern, Bewegung folgt nicht echter Physik. Das sind lösbare Probleme, sobald man versteht, was sie verursacht. Das Problem ist nicht, dass die Modelle schlecht sind. Das Problem ist, dass Generierung und Konsistenz unterschiedliche technische Probleme sind und die meisten Tools nur das zweite teilweise lösen.
01
Wie KI-Videogenerierung tatsächlich Frames erzeugt
Aktuelle Videogenerierungsmodelle sind überwiegend diffusionsbasiert – sie starten aus Rauschen und verfeinern es schrittweise zu einer Ausgabe, die dem Konditionierungssignal entspricht: Ihrem Prompt, Referenzbildern oder beidem. Die Verfeinerung geschieht in einer komprimierten Darstellung des visuellen Raums, dem sogenannten Latent Space, und nicht direkt auf den Pixelwerten – das ist einer der Gründe, warum Generierung auf aktueller Hardware überhaupt praktikabel ist.
Die Unterscheidung zwischen Frame-für-Frame-Generierung und zeitlicher (temporaler) Generierung ist für die Ausgabequalität enorm wichtig. Frame-für-Frame-Modelle erzeugen jedes Bild unabhängig mit etwas geteiltem Kontext – sie sind schnell, erzeugen aber Flackern, weil jedes Bild eine leicht andere Lösung desselben Prompts ist. Temporale Modelle modellieren Bewegung explizit über die Zeit, was zu glatterer Ausgabe führt, aber deutlich mehr Rechenleistung erfordert.
Die meisten für Endnutzer verfügbaren Tools verwenden eine Kombination aus temporalen Attention-Mechanismen, die benachbarte Frames miteinander verknüpfen, während sie für längere Sequenzen weiterhin unabhängige Generierung zulassen. Dieses Verständnis der Architektur erklärt, warum kurze Generierungen tendenziell konsistenter sind als lange – das Zeitfenster der temporalen Attention hat Grenzen.
02
Zeitliche Konsistenz: warum sie technisch schwierig ist
Zeitliche Konsistenz bedeutet, dass Objekte, Texturen und Beleuchtung über die Frames hinweg so stabil bleiben, wie es dem Verhalten der physischen Welt entspricht. Für Menschen ist es kinderleicht zu bemerken, wenn das misslingt – wir haben unser ganzes Leben damit verbracht, die physische Realität zu beobachten –, aber in einem generativen Modell ist es wirklich schwer durchzusetzen.
Das Kernproblem ist, dass Diffusionsmodelle jede Lösung einigermaßen unabhängig erzeugen, selbst wenn sie auf vorherige Frames konditioniert sind. Kleine Abweichungen im Entrauschungspfad führen auf Pixelebene zu sichtbar unterschiedlichen Ergebnissen, auch wenn der semantische Inhalt identisch ist. Diese Abweichungen summieren sich über die Frames und äußern sich als Flackern.
Modelle begegnen dem mit mehreren Mechanismen: Optical-Flow-Constraints, die Pixelkonsistenz zwischen benachbarten Frames erzwingen, Attention-Mechanismen, die Merkmale über die Zeitdimension weitergeben, und explizite Bewegungskonditionierung, die verankert, wie sich Objekte bewegen sollen. Kein aktuelles Modell löst alle drei gleichzeitig bei hoher Auflösung perfekt.
03
Prompt-Engineering für konsistentere Ausgabe
- Stil-Anker: Nehmen Sie konkrete visuelle Stilbegriffe auf („Cel-Animation", „sauberer Vektor", „fotorealistisch") – sie schränken den Generierungsraum ein und verringern die Varianz
- Negative Prompts: Schließen Sie gängige Artefakttypen ausdrücklich aus („Flackern", „Morphing", „verzerrte Kanten") – Modelle reagieren auf negative Konditionierung
- Seed-Kontrolle: Fixieren Sie den Generierungs-Seed, wenn Sie ein funktionierendes Ergebnis iterieren – das bewahrt den Initialisierungszustand, der die gute Ausgabe erzeugt hat
- Referenzbilder: Die Konditionierung auf ein Stil-Referenzbild erzeugt deutlich konsistentere Farben und Texturen als reine Prompt-Generierung
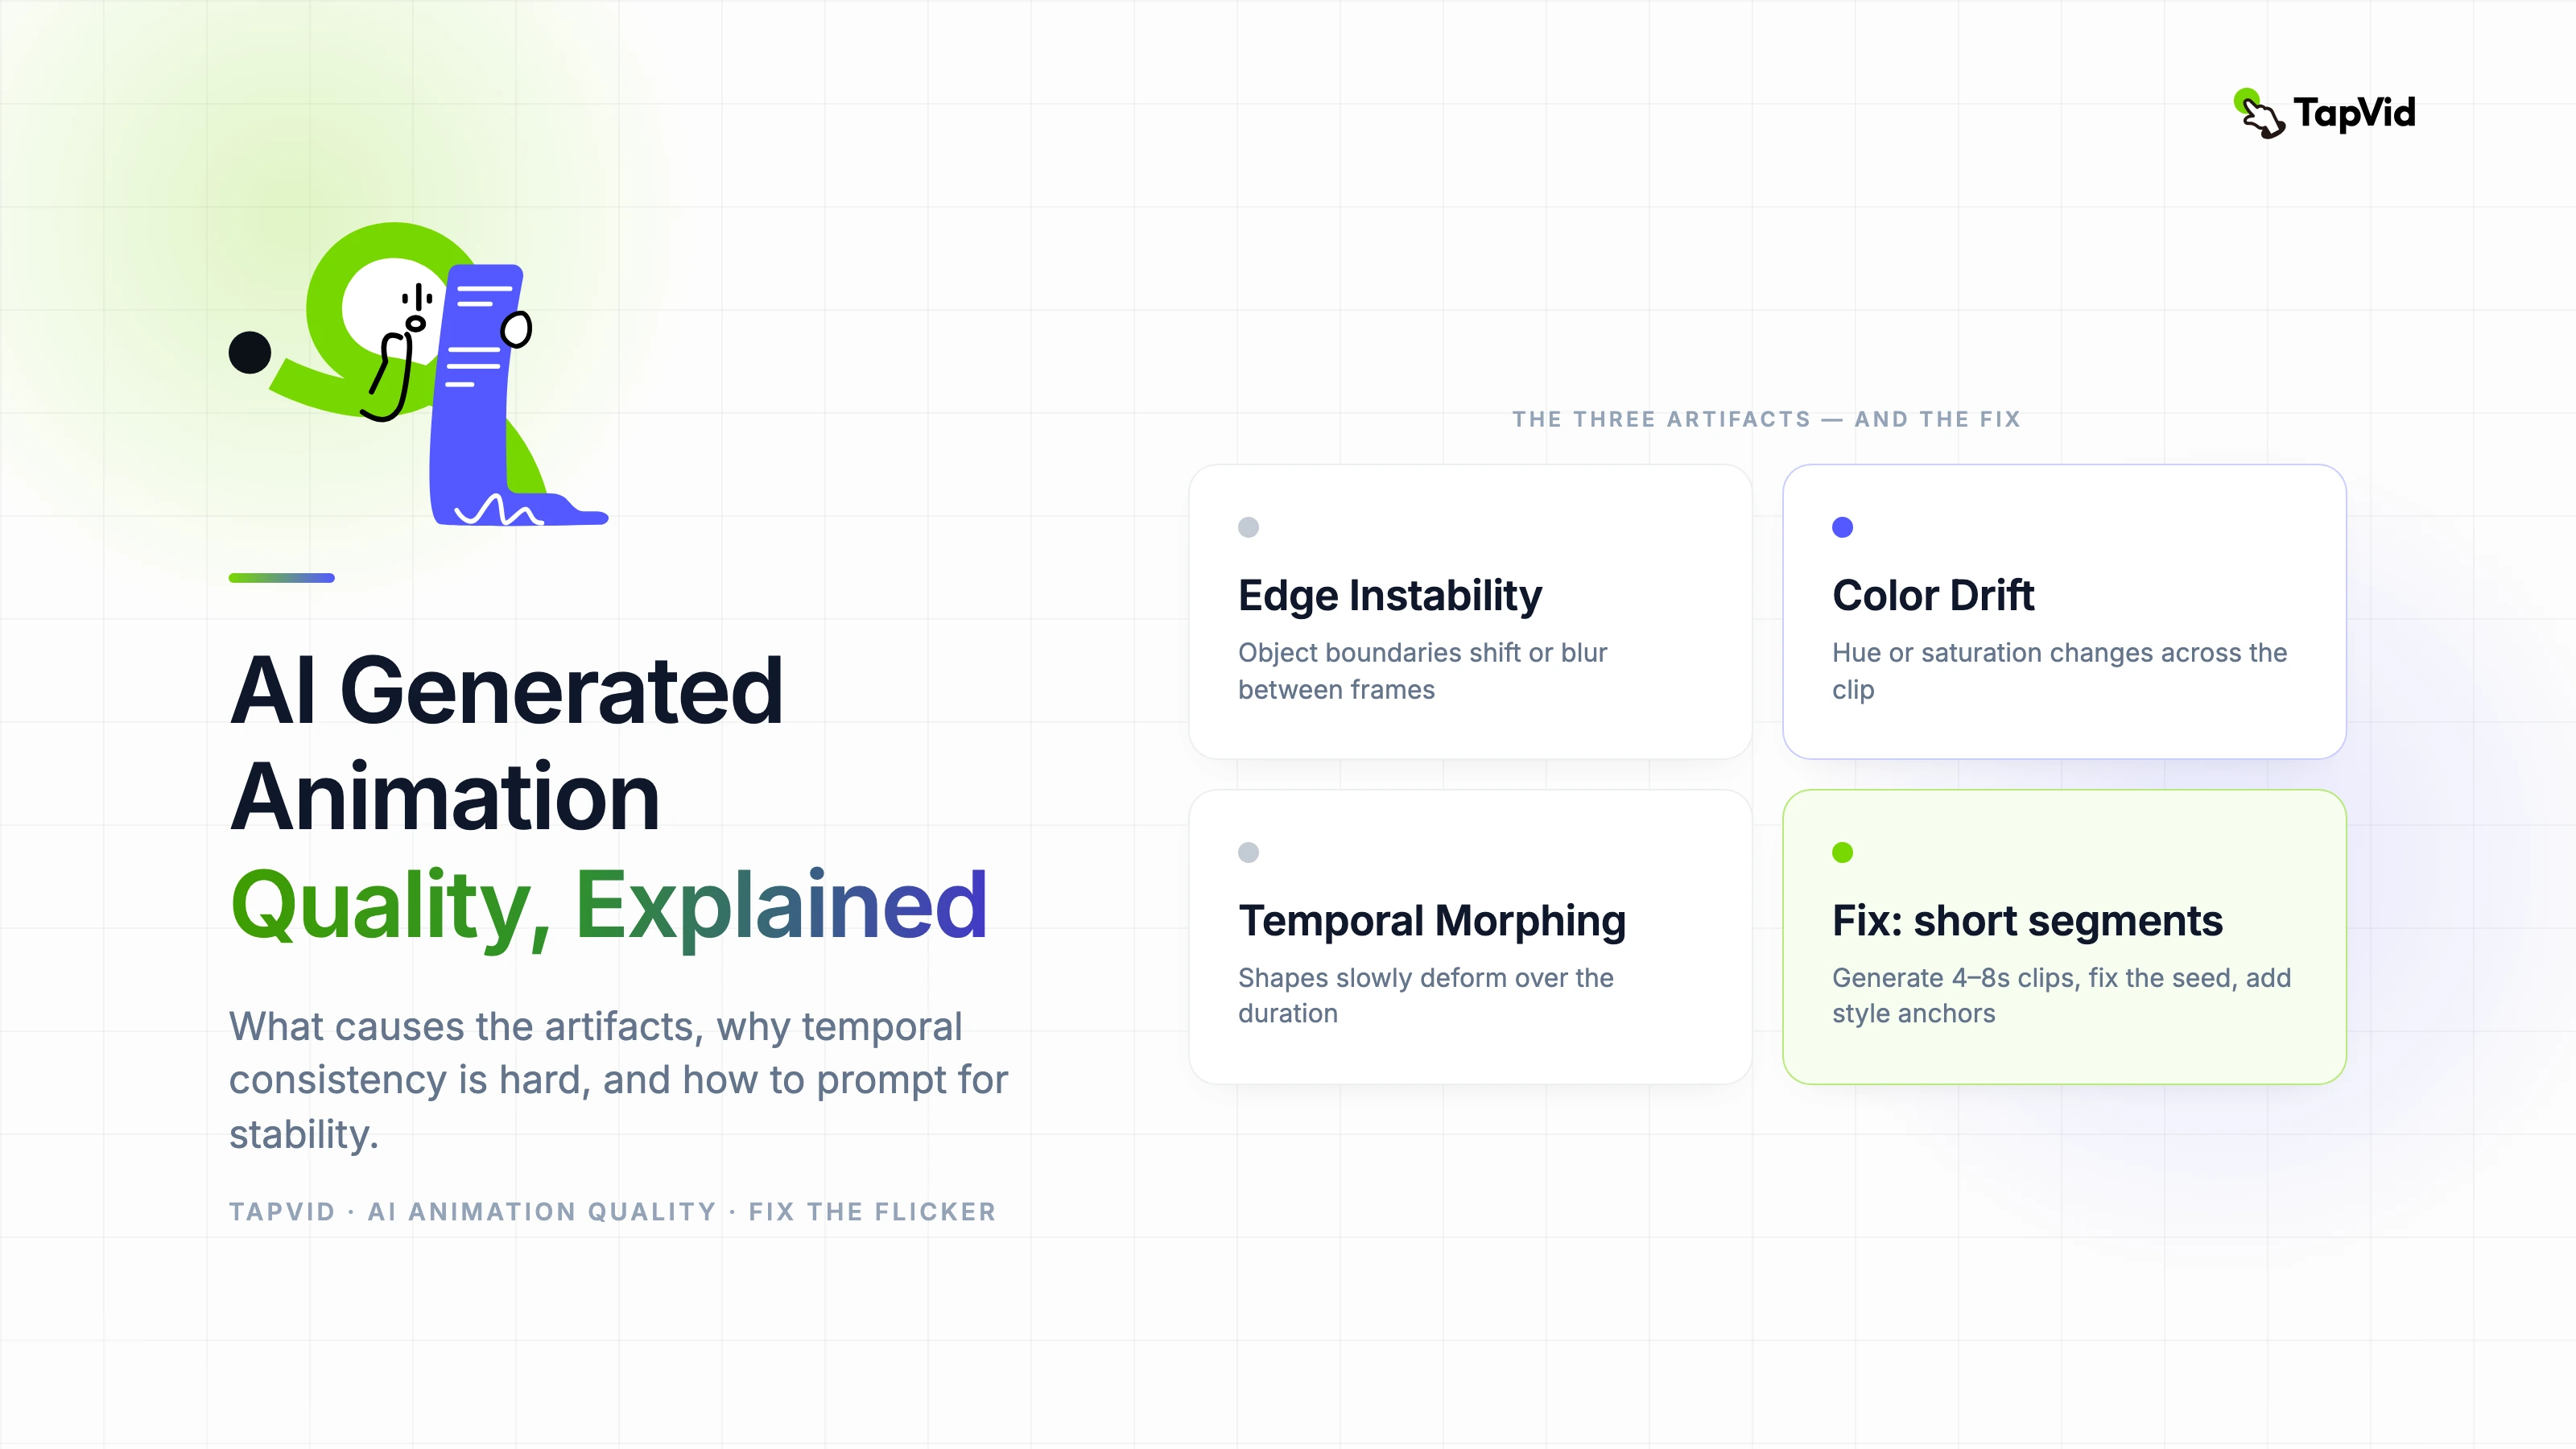
- Kurz halten: Generieren Sie in Segmenten von 4–8 Sekunden für beste Konsistenz – längere Generierungen sammeln mehr zeitliche Drift an
04
Wie man KI-Animationsausgaben systematisch bewertet
Rahmenschrubben Sie den Ausgang einmal mit 1× Geschwindigkeit, dann wieder mit 25 % Geschwindigkeit. Achten Sie auf die drei häufigsten Artefakttypen: Kanteninstabilität (Objektgrenzen, die sich zwischen Frames verschieben oder verwischen), Farbdrift (Farbton oder Sättigung, die sich über den Clip hinweg ändert) und zeitliche Morphing (Objektformen, die sich im Laufe der Dauer langsam verformen).
Für jeden Clip, der in einem professionellen Kontext verwendet wird, exportieren Sie eine Bildsequenz und überprüfen Sie einzelne Frames mit 100% Zoom. Kompressionsartefakte im Videoformat können Qualitätsprobleme ausblenden, die auf Bildebene sichtbar sind.
Vergleichen Sie Ihre Ausgabe mit demselben Prompt, dreimal mit unterschiedlichen Seeds ausgeführt. Ist die Varianz zwischen den Durchläufen hoch, ist die Generierung nicht stabil und erfordert für jede Ausgabe erhebliche manuelle Qualitätskontrolle. Ist die Varianz gering, haben Sie einen zuverlässigen, wiederverwendbaren Prompt gefunden.
05
Wo KI-Generierung die klassische Animations-Pipeline übertrifft
Die Geschwindigkeit der Stilexploration ist der deutlichste Vorteil. Zehn visuell unterschiedliche Interpretationen eines Bewegungskonzepts in dreißig Minuten zu generieren – Arbeit, die mit klassischen Tools Tage bräuchte – verändert, wie kreative Entwicklung in der Frühphase funktioniert. Die Investition in die klassische Produktion muss nur noch für die Richtung erfolgen, die validiert wurde.
Abstrakte und nicht gegenständliche Bewegung ist ein Bereich, in dem Generatoren durchgängig glänzen. Bewegte Hintergründe, Partikelsysteme, Fluiddynamik und geometrische Transformationen liefern zuverlässig hochwertige Ausgaben, weil keine Charakter- oder Objektkonsistenz gewahrt werden muss.
06
Aktuelle harte Grenzen – und was besser wird
Charakterkonsistenz über Szenen hinweg bleibt die bedeutendste ungelöste Einschränkung. Ein in einer Szene generierter Charakter sieht in einer zweiten Szene merklich anders aus, sofern keine gezielte Konsistenzkonditionierung angewendet wird. Aktuelle Lösungen (Referenzbilder, ControlNet-artige Konditionierung) helfen, lösen das Problem aber nicht vollständig. Das schränkt narrative Animation stark ein.
Am schnellsten verbessern sich Ausgabeauflösung, Generierungsgeschwindigkeit und Stilkontrolle. Am langsamsten verbessern sich das semantische Verständnis – die Fähigkeit des Modells, komplexe räumliche und zeitliche Anweisungen präzise zu befolgen – und die physikalische Plausibilität, besonders bei Starrkörperdynamik. Rechnen Sie in den nächsten zwölf Monaten mit deutlichen Fortschritten bei Auflösung und Geschwindigkeit; Charakterkonsistenz und Physik dürften noch länger nur teilweise gelöst bleiben.