TL;DR
在資訊密集的影片上,TapVid 處於領先地位。
此 AI 影片基準測試是為必須 inform(指導性、編輯性、解釋性)而不是娛樂性的影片而建造的。在其針對資訊密集的場景中,TapVid 在事實覆蓋率方面完全領先,在 TeachQuiz 資訊交付方面並列第一,並且在七個系統中的整體品質名列前茅。獨立的行業標準自動化指標 VBench 再現了人類小組的偏好,證實了評估的嚴謹性。
AI 影片基準測試結論:首先專注於重要內容—其他方面保持平衡
資訊密集的場景——專業、新聞、操作指南、教育——是基準測試的目標領域,也是 TapVid 獲勝的地方。在所有 25 個場景中,TapVid 的資訊品質在 7 個場景中排名第二, 是唯一在兩個資訊軸上都強大的程式碼渲染器 。
整體品質 — 資訊豐富 + 美觀
75.2 T
在資訊密集型工作中排名第 1(共 7 個) — 唯一同時在每個軸上都很高的系統。
美感偏好 vs Fable 5,資訊領先者
58.7%
在並排觀看中優於該領域的頂級資訊系統 - 並且明顯不輸。
事實涵蓋 - 資訊密集的場景
83.6%
徹底的領域領先。在螢幕上顯示所需事實方面明顯領先於 6 名競爭對手中的 5 名。
TeachQuiz 訊息傳遞-資訊密集場景
84.5%
並列第一。觀眾在 TapVid 後回答理解問題的效果與在該領域的任何系統後一樣好。
整體品質-資訊豐富+美觀·資訊密集的場景
(內容保真度 + 視覺品質 + 美感偏好)/ 3 · 場相對 T 分數(70 = 場平均值,10 = 1 SD)
這兩個框架隨處可見。 標題聲稱使用資訊密集框架 (UC1–UC4) 作為基準目標 - 如圖所示,其中 TapVid 總體品質名列前茅;在所有 25 個場景中,TapVid 的資訊品質在 7 個場景中排名第 2(T 78 vs Fable 5 85)。帶有信賴區間的完整記分卡位於附錄。
專為必須提供資訊而非娛樂的影片而打造
五個用例中的每一個都藉鑒了 現實世界的源材料 ,並在五個意圖驅動的場景中進行評估:簡介指定了觀眾應該離開的事實,人類註釋者衡量他們是否這樣做。目標是資訊密度高、意圖明確的影片——指導性、社論性、解釋性——而不是美學或娛樂內容。
該領域-七個系統,兩個範式
| 系統 | 線束/模型 | 家庭 |
|---|---|---|
| TapVid | 程式碼渲染視頻 | 程式碼渲染 |
| Fable 5 | Claude Code · Fable 5 | 程式碼渲染 |
| 程式碼渲染 H | Claude Code · Sonnet 5 | 程式碼渲染 |
| 程式碼渲染 R | Codex · GPT-5.5 | 程式碼渲染 |
| 像素擴散L | 官方工作室·專業模式,1080p | 像素擴散 |
| Seedance | Seedance 2.0 · Jimeng · VIP模式,720p | 像素擴散 |
| Veo | Veo 3.1 · Google Flow · 品質模式,720p | 像素擴散 |
所有系統均於 7 月 6 日至 12 訪問 2026:本地運行的工具於 7 月 6 日凍結在最新版本,在其官方平台上以最新旗艦型號託管系統 - 每個系統均採用最高質量設置 16:9。確切的版本引腳及其來源請參閱附錄 A。
五個用例,真實世界的來源材料
| 使用案例 | 素材來源 |
|---|---|
| 專業企業/自學 | GDPval 任務 — 專業與技術服務、政府、製造、金融 |
| 新聞社論 | 2025-26 期封面:《經濟學人》、《金融時報》、《彭博》、《自然》、《科學》 |
| 生活方式指南 | 熱門 #HowTo YouTube — 工藝/DIY、藝術、健身、心態、謎題 |
| 講解員教育 | 觀看次數最多的「AP 考試解釋」—歷史、心理學、微積分、生物學、地理 |
| 行銷產品/銷售 | 納斯達克最具價值公司跨行業發布視頻 |
產生前固定的取樣規則。 每個用例都按照預先定義的規則繪製五個場景 - 對來源池進行聚類,每個聚類隨機採樣一個(頂級行業、出版物、內容類別、AP 主題、納斯達克板塊)。每個簡報都是一個完整詳細的視頻生成提示,攜帶完整的信息有效負載,在任何系統生成任何內容之前編寫和 凍結;其所需事實清單(基準中的 168 個事實)和理解問題(149 個)是同時編寫並經過人工審核的。完整的範例位於附錄 B 中。
球場是如何進行的——一次射擊,同樣的簡短,頂級設置
- 相同的輸入: 每個系統都收到相同的簡短逐字記錄 - 每個系統零提示工程。
- Best-of-1: 每個場景世代,從未規劃;重試硬故障直至成功(最多觀察 3 次重試)。
- 產生的持續時間:簡報設定的目標長度;每個系統的實際輸出原樣使用(系統平均值 1.1–4.2 分鐘)。
- 173/175會計: Fable 5的安全規則拒絕了25份簡報中的2份。我們沒有替代 Opus 的後備方案,而是僅在其 23 代上對 Fable 5 進行評分——沒有競爭對手被悄悄削弱,缺失的單元格從分母中刪除,從未進行估算。
註釋器面板-獨立、盲目、完全交叉
- 12名獨立標註者,不隸屬於任何系統團隊的外包自由工作者-均擁有QS世界排名前50名大學的碩士學位或以上學位,並具有經過認證的英語能力。
- 盲通:影片以隨機順序呈現,未標記;註釋者從未被告知哪個系統產生了視訊。
- 完全交叉: 所有 12 個註釋者對所有 7 個系統進行了評分,每個影片有兩個評分者 - 嚴格或寬鬆的評分者會平等地移動每個系統,並且不會使比較產生偏差。
- 刻意觀看,非點擊式工作: 每個5分鐘以下的影片註解約20分鐘,以當地最低工資的4倍支付。註 2026 年 7 月 13 日至 15 日。
以已發布的方法為基礎、由人測量的指標
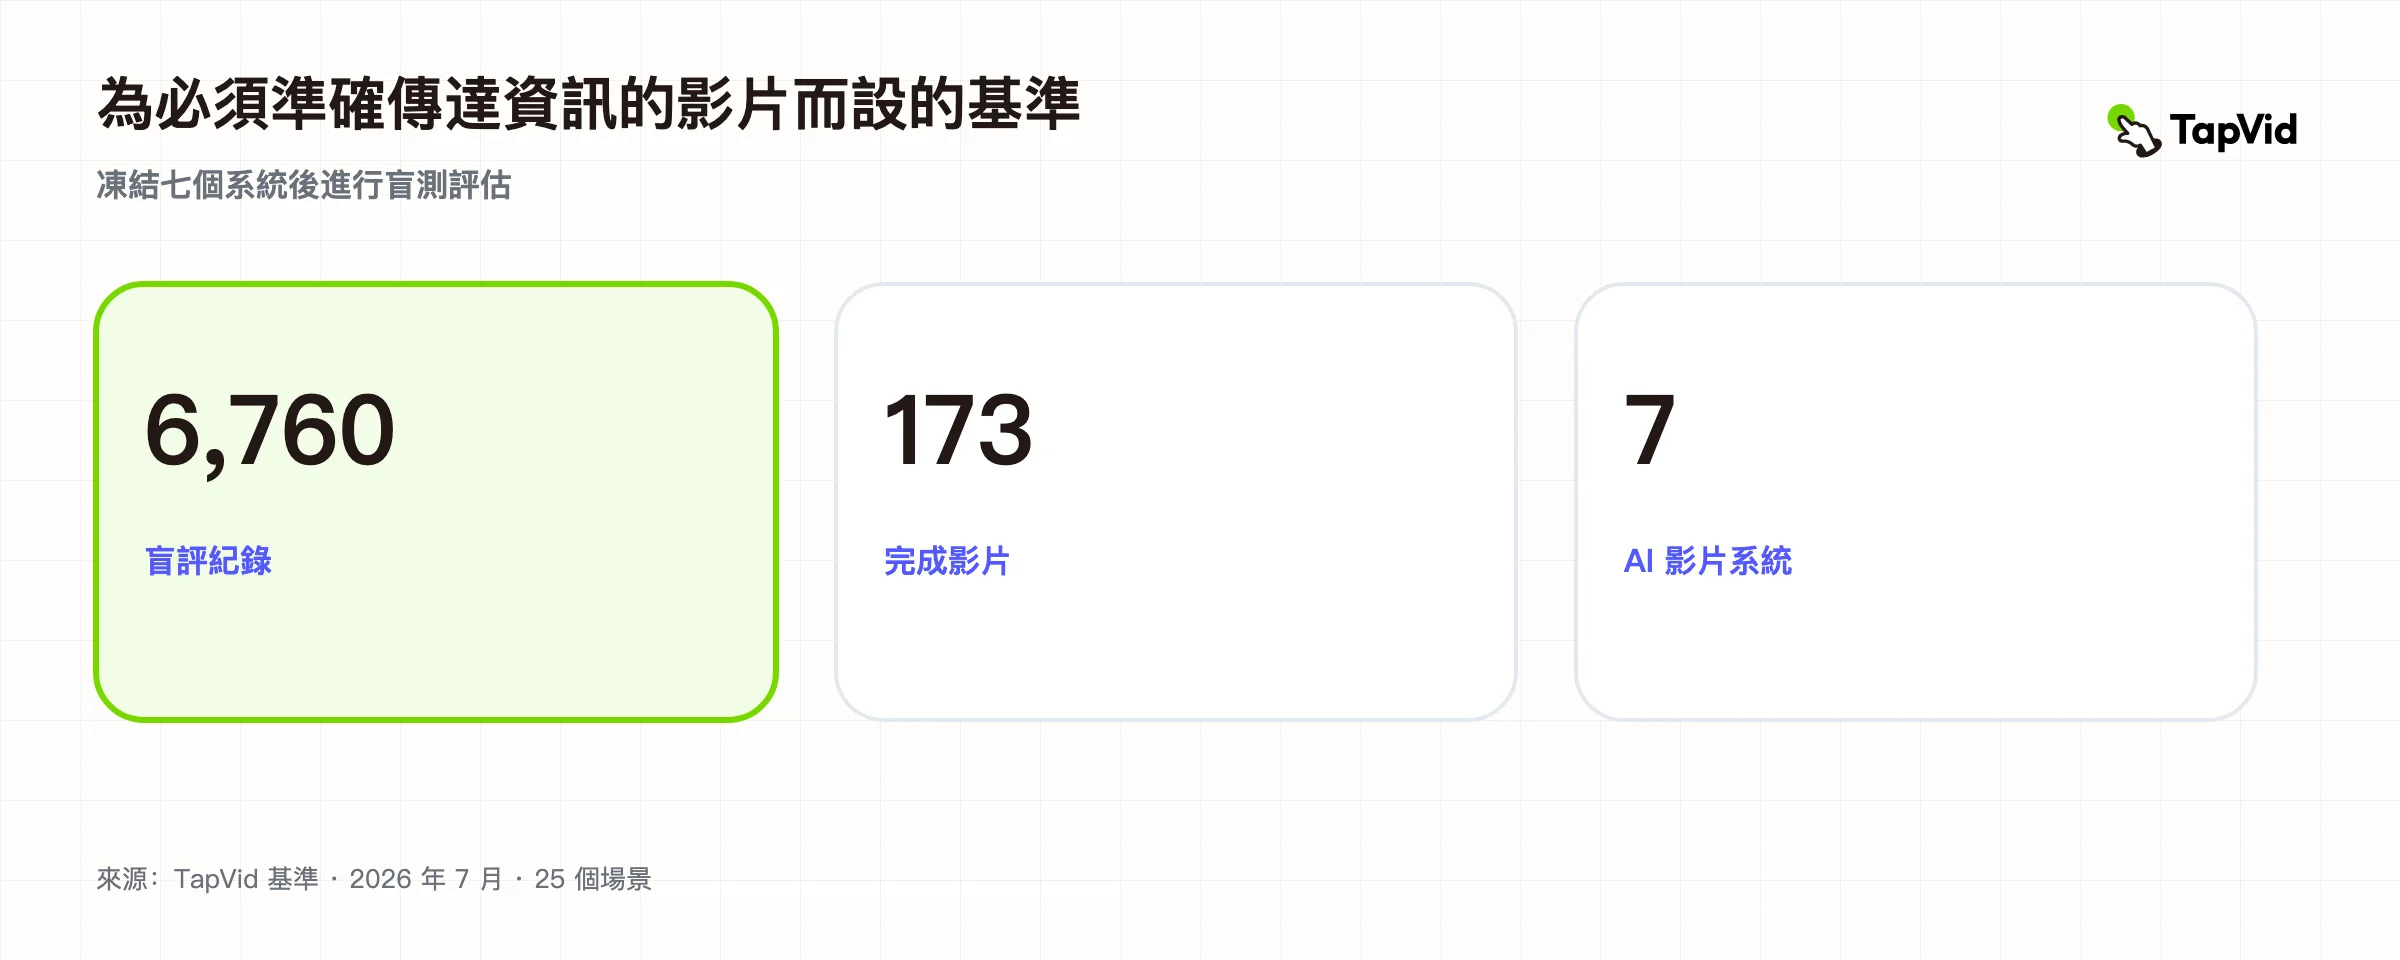
每個影片均由 全交叉註釋器面板 進行評分 - 每個註釋者都對每個系統進行評分,因此嚴格或寬鬆的評分者會平等地移動所有系統,並且不會使比較產生偏差。該小組根據已發布的方法在五個站點生成了 6,760 個人工註釋 (其中三個在 ICML、WACV 和 IEEE TPAMI / CVPR 進行了同行評審),並且每個視頻模型也由 ZXQQZXZXZQZQZXZXZ: >370萬幀級模型評測 。
- TeachQuiz 訊息傳遞 (Code2Video、ICML 2026 · arXiv:2510.01174) — 觀看者實際獲得了多少預期資訊。
- 事實報導 - 簡報所需的事實,有多少出現在螢幕上,逐字且清晰。
- T2VTextBench 文字準確度 (arXiv:2505.04946) — 螢幕標題、數字和標籤的正確性。
- T2VWorldBench ( WACV 2026 · arXiv:2507.18107) — 四個品質維度:視訊品質、真實性、相關性、一致性。
- 美感偏好-競技場風格,與TapVid並排比較。
- VBench(VBench++、IEEE TPAMI 2025 · 原始 VBench、CVPR 2024 亮點 原始 VBench、CVPR 2024 亮點ZX 自動化行業 設計>370萬幀級模型評測 。
VBench 是 的一個獨立的、基於機器的對人類註釋的交叉檢查 :它的幀質量評估再現了我們人類的偏好排名,因此這兩個儀器相互印證(發現 05)。
排名對於您如何計算它們來說是穩健的:三個獨立的估計器——原始率、留一資訊增益和混合效應邏輯模型——產生相同的排序,可靠性加權和PCA變體保持不變。由於行銷表現為與四個資訊密集用例不同的任務系列,因此 每個結果都在兩個框架中報告::所有 25 個場景,以及資訊密集框架(專業、新聞、操作方法、解釋器)。兩者的完整表格都在附錄。
資訊視訊是一個權衡前沿——TapVid 佔據了平衡點
WIN 該領域是一個權衡前沿:在資訊品質上,順序是 Fable 5 > TapVid > 其他人;在美學偏好上,順序完全相反。 TapVid 是唯一在兩個資訊軸上都很高的程式碼渲染器 - 內容保真度 77,視覺品質 79,每個軸上都是 7 中的第二個 - 前緣的平衡點。
美學偏好是透過競技場風格進行測量的——並排放置兩個相同簡介的影片——並捕捉了資訊性標題所沒有的東西:它與每個資訊性指標的相關性都是負到零(-0.22 到 -0.01)。程式碼渲染器購買資訊品質;像素擴散帶來了美學吸引力。下面的邊界將兩個框架中的所有七個系統都置於這種權衡之上。
資訊美學前沿
x:資訊品質 · y:美感偏好 · 場相關 T 分數(70 = 場平均值) · 資訊密集場景
TapVid 是綠色象限中唯一的系統——資訊豐富且美觀——在兩個框架中。 邊界正在走下坡路:資訊品質排序 Fable 5 > TapVid > 其餘,而美學偏好將其端對端顛倒。在信息密集的场景中,TapVid 移动到前沿的肘部(信息质量 82,领先者的 3.5 T 范围内),而像素扩散美学边缘缩小到奇偶校验;在所有 25 个场景中,Seedance 和像素扩散 L 都位于所示的偏好范围之上。審美偏好與資訊品質一起報告,但從未對其進行平均。
TAPVID 的美學勝率 — 並排觀看,所有 25 個場景
並排比較 TapVid 獲勝的份額(平手佔一半)·×100
50 以上 = 觀眾偏好 TapVid。混合邏輯非損失/決定性勝利測試的意義;完整的CI和無損幀在附錄。
TAPVID 的美學勝率 — 並排觀看、資訊密集的場景
並排比較 TapVid 獲勝的份額(平手佔一半)·×100
在基準測試的目標領域,美感缺陷縮小到同等級——在決定性比較中,只有 Seedance 仍然明顯受到青睞。
WIN 與 Fable 5(該領域資訊豐富的領導者)並排顯示,觀眾更喜歡 TapVid。勝率58.7%,TapVid顯著不輸(P = 0.72)。在質量合成上擊敗 TapVid 的系統在觀眾面前輸給了 TapVid。
WIN 在資訊密集的作品中,TapVid在引領內容的同時,在美感上毫不妥協。整體無損率上升到 53.0%(奇偶校驗),沒有任何像素擴散系統具有顯著的無損優勢。與 Google 的 Veo 相比:在資訊品質上領先(78 比 65),在覆蓋範圍上顯著領先,並且偏好搖擺不定。
限制 在所有 25 個場景中,美學偏好是一個真正的弱點。 TapVid 的整体胜率是 40.7%,明显低于 50% 的无偏好线,而且它的受欢迎程度明显低于 Pixel-diffusion L 和 Seedance(信息排名垫底)。倒置是範式權衡,集中在行銷;收尾計劃直接解決了這個問題。
在螢幕上顯示事實是約束條件-TapVid 做得最好
获胜 在信息密集的场景中,TapVid 在屏幕上显示了 83.6% 的所需事实 — 绝对领先,明显领先于 6 个竞争对手中的 5 个。在所有 25 個場景中,它在統計上與領先者 Fable 5 並列,並且明顯領先於每個像素擴散系統。
覆蓋範圍是基準測試最具辨別力的指標:該領域分為兩個乾淨的層,四個程式碼渲染器(螢幕上的事實的 74-79%)遠離三個像素擴散系統(54-61%)。
事實覆蓋率——螢幕上所需事實的比例
平均值 · 95% 場景引導 CI · 資訊密集情境 · ×100
資訊密集影格:TapVid 83.6 [77.3–89.0] 領先 ;除 Fable 5 外,與每個系統的差距均具有統計顯著性(混合對數 95% CI 排除 0)。 All-25 幀:Fable 5 79.0、TapVid 77.3(統計上並列),Seedance、Veo 和像素擴散 L 在這兩個幀中都明顯落後。
覆蓋率推動交付 — 每個視頻 1 分,173 個視頻
x:事實覆蓋率·y:TeachQuiz 訊息傳遞(正確率)·×100
獲勝 一旦事實出現在螢幕上,觀眾大約 95% 的時間都會了解它。 173 個影片的覆蓋率和投放率在 r = 0.70 處相關,擬合線從 36% 的非事實下限到 96% 的螢幕上限。理解幾乎是一個已解決的步驟——遊戲是覆蓋範圍,而 TapVid 發揮得最好。
按用例劃分的覆蓋範圍 — 模型預測的 P(螢幕上的事實)
每個用例的混合對數預測機率·×100
WIN TapVid 在五個用例中的四個中領先或並列覆蓋率領先。它完全領先於新聞 (81.9) 和操作方法 (86.7),而在專業方面,它明顯領先於四個競爭對手,包括總體領先者 Fable 5。
限制 行銷是個例外。 TapVid 的覆蓋率下降到 53.8% — 位於程式碼渲染器的底部,位於 Fable 5、Code-render R 和 Code-render H 後面。每個指標的 Marketing 列都存在相同的差距;結束計劃將其視為一個問題。
觀眾從 TapVid 中學到的知識與從該領域的任何系統中學到的知識一樣多
在資訊密集的場景中,TapVid 在 TeachQuiz 訊息傳遞方面並列第一——觀眾正確回答了 84.5% 的理解問題——並且顯著超過了三個系統(程式碼渲染 H、Seedance、像素擴散 L)。在所有 25 個場景中,前五名在統計上是密不可分的;TapVid 明顯領先於 Pixel-diffusion L 和 Seedance。
交付遵循 TeachQuiz 協議:觀看後,註釋者回答有關摘要所需事實的多項選擇問題,並且每個影片都會根據每個問題欄位基線進行評分。三個獨立的估計器——原始正確率、留一資訊增益和混合效應邏輯——就排序達成一致。
教學測驗訊息傳遞-理解正確率
原始正確率·顯著性與混合效果 Logit 中的 TapVid·資訊密集場景·×100
TapVid 在这两个框架中都是顶级的。完整的每個用例的贏/平/輸錶位於附錄。
按用例交付 — 理解正确率
每個用例的原始正確率 · 在用例場景中具有 95% 引導 CI 的條形 · ×100
TapVid 在新聞 (88.3) 和操作指南 (89.7) 上名列前茅 - 根據混合邏輯推理,它在新聞上的代碼渲染 R、像素擴散 L 和 Seedance 以及在操作方法上的 Veo 都顯著優於 ZXQQZ16。專業人士和解說員屬於中場;行銷是結束計畫 目標的差距。每個用例依賴 5 個場景,因此 CI 很寬;重要性呼叫來自附錄中的每個用例混合logit。
T2VTEXTBENCH 文字準確性 — 螢幕上的標題、數字和標籤
四層等級映射到 [0,1] · 95% bootstrap CI · 資訊密集場景 · ×100
WIN TapVid 在資訊密集的場景中渲染螢幕文字效果最佳。在所有 25 個場景中,從統計數據來看,該領域的頂尖選手是不可分割的。
在四個視覺維度中的三個維度上與領先者統計並列
獲勝 在 T2VWorldBench 人類評估中,TapVid 在真實性、相關性和一致性方面在統計上與領先者 Fable 5 並列(在兩個幀中),並且在四維合成中排名 7(86.4),明顯領先於 Seedance 和像素擴散 L。無論 TapVid 渲染什麼,它都渲染得很乾淨。
交叉註釋器面板根據每個維度的評分標準對四個維度進行 1-5 級評級。與 Fable 5 的一個顯著視覺差距是視訊品質(86.0 vs 90.0);其他三個維度是統計連結。
T2VWORLDBENCH — 四個維度,全部 25 個場景
平均等級 · 95% 場景引導 CI · ×100 · * = 與 TapVid 相比顯著
TapVid 在品質、真實性和一致性方面排名第二,在相關性方面排名第三(位於 Fable 5 和程式碼渲染 R 之後)。相關性——「它是否說了正確的事情」——表現為內容維度,並使用上面的內容指標進行分析。
獲勝 如果評分者完全同意,TapVid 評分最高。在精確協議子集上,TapVid 的視訊品質上升到 0.97,超過了 Fable 5——TapVid 的明顯勝利是明確的。
透過 VBench 產業標準自動化指標驗證的人工註釋
檢查 在相同的 25 個場景中盲目運行,VBench(公共 HuggingFace 排行榜背後的自動化模型)獨立於人類小組對每個影片進行評分。它對系統進行排序的方式與我們註釋者的並排偏好相同。 Spearman VBench 框架品質與人類偏好之間 ρ = +0.89; +0.87 排除任何一個系統。人類偏好軸並不是我們的評估者的產物──一個獨立的、紙本的機器指標也遵循同樣的順序。
一個廣泛使用的自動化模型,在不了解人類標籤的情況下進行計算,與人類小組對系統排名的看法一致——這證明評估捕捉到了真實的、可再現的信號,而不是評估者的特質。
自動化和人類儀器一致——顯示的每個視頻
x:VBench 每個視頻的幀質量(自動) · y:每個系統的人類獲勝率 · 141 個系統×場景視頻,按系統著色 · ×100
E每個小點是一個視頻的自動幀質量,由系統著色並按該系統的人類獲勝率放置;大點是系統的意思。 彩色雲按勝率順序堆疊,它們的中心從左到右爬升 - 自動幀質量和人類偏好將系統排列在一起( Spearman ρ = +0.89 )。系統未命名:重點是兩個儀器的一致,而不是任何一個系統的立場。
SRC VBench(VBench++、IEEE TPAMI 2025·原始 VBench、CVPR 2024 亮點)是公共 HuggingFace 排行榜背後的標準自動視訊品質基準,對每個剪輯進行六個維度的評分。它於 7 月 13 日至 14 日在專用 GPU 上使用官方 VBench-Long 程式碼路徑(提交 e946a8d)運行——在與人類標籤進行任何比較之前完成。幀質量頭(美學+成像質量)是這裡使用的美學交叉檢查,計算工作時的質量,因此失敗的一代不會扭曲系統的分數。每個合成都是根據每個場景的原始分數重新計算的,並將來源報告與小數點相匹配;完整的運行方案見附錄 A。
兩個目標:行銷內容和美學吸引力,無需資訊交易
這兩個差距都是經過衡量的、局部的,並且與已經有效的東西是分開的。兩者都不需要觸及贏得資訊密集領域的覆蓋和交付引擎。
按使用案例劃分的 TAPVID — 行銷差距在於內容,而不是渲染
內容保真度與視覺品質綜合·相對於現場的 T 分數·每個用例
在行銷方面,TapVid 的視覺品質保持在 75,而內容保真度則下降到 51 - 視訊渲染乾淨,但錯過了所需的事實。在其他地方,兩個軸以 68-93 的比例一起移動。
美學計畫-提升美學軸,保持資訊領先
x:資訊品質·y:美感偏好·T 分數·所有 25 個場景
因為偏好與每一個品質指標都是正交的,所以這一舉措是 直接上升的 ——提高運動、潤色和吸引力將 TapVid 移向前沿的空白右上角,而無需花費任何資訊領先。
下一個勝利結束 #1 — 行銷內容。崩潰是行銷場景中的事實傳遞,而不是渲染——覆蓋引擎的有針對性的擴展,已經導致了四個用例,而不是重建。關閉它會將 TapVid 的資訊密集覆蓋領先優勢轉變為全領域領先優勢:不包括行銷,TapVid 已經在覆蓋範圍的六個系統中名列前茅。
NEXT 獲勝結束 #2 — 美感偏好與像素擴散,但不放棄資訊領先。從經驗上看,偏好與每一個品質指標都是正交的,因此關閉它是它自己的程序——動議、潤色、吸引力——而不是被迫反對覆蓋或交付的交易。資訊密集的框架顯示了天花板:在內容密集的地方,TapVid 已經達到偏好平價,同時保持內容領先。
凍結協議、種子統計、每個結果都是完整的
系統版本與來源固定;採樣規則和事實清單在任何視頻出現之前就已確定;註釋器面板是盲的並且完全交叉(A-B)。三個獨立的估計者就每個順序達成一致,所有隨機性都被播種,獨立的重新運行再現了每個工件(C-E)。在兩個框架 (F–K) 中完成每個指標的排行榜以及每個指標的置信區間。除非另有說明,Δ 列是與 TapVid 的混合對數對數賠率對比; WIN / LOSS = 從 TapVid 的角度來看,95% 區間不包括零;
KEY 系統命名。本報告正文透過匿名標籤引用了三個系統。他們的真實身分僅在此說明:程式碼渲染 H = Hyperframes · 程式碼渲染 R = Remotion · 像素擴散 L = LTX。下表使用真實的產品名稱。
A · 實驗協議——版本、時間軸、註釋帳本
時間線(2026)。 摘要+事实清单在7月6日之前编写和冻结→系统7月6日冻结→所有代7月6-12日→VBench-Long评分7月13-14日→人工注释7月13-15日(第一次回复7月13日09:41,最后7月15日04:33)→统计和人类↔VBench 比对,7 月 14 日至 16 日。 VBench 評分在任何人類標籤比較存在之前完成。
版本 pin — 截至 7 月 6 日凍結的最新版本的本地運行工具;視窗期間的最新旗艦機型託管平台。每個平台均提供所有 16:9、最高品質設定、分鏡/規劃功能。
| 系統 | 版本·平台·设置 | 來源 |
|---|---|---|
| TapVid | 存取視窗的內部建置目前 | — |
| Fable 5 | Claude Code 2.1.202 · 模型 claude-fable-5 (6 月 9 日宣布,7 月 1 日重新部署) · 默認 | 公告 · 變更日誌 |
| Hyperframes | v0.7.37 · Claude Code · Sonnet 5(6 月 30 日發布) · 默認 | 發布 · Sonnet 5 |
| Remotion | v4.0.485 · Codex CLI 0.142.5 · GPT-5.5(4 月 23 日發布;GPT-5.6 凍結後於 7 月 9 日發布) · 默認 | 發布 · Codex · GPT-5.5 |
| Veo | Veo 3.1(2025年10月15日發布) · Google Flow,Flow 的故事板規劃 · 品質模式,720p | 公告 · 模式文件 |
| LTX | LTX-2.3(2026 年 3 月發布) · LTX Studio,LTX Studio 使用 GPT-Image-2 進行故事板規劃 · Pro 模式,1080p | 發布 · GPT-Image-2 |
| Seedance | Seedance 2.0(2月12日公布)·Jimeng——字节跳动官方消费平台——代理模式,故事电影技巧·VIP模式(顶级画质),720p | 公告 · Jimeng |
提示出处。 所有 25 份摘要及其事實清單均由 Claude Opus 在 Claude Code 上編寫,經過人工審核,並在生成開始之前凍結。如果人工智慧作者的簡介偏向任何系統的習慣用法,那麼受益者將是 Fable 5(競爭對手),而不是 TapVid。
6,760 個註記分類帳。 每個註釋者 × 場景 × 系統 × 項目一行:事實檢查 2,326(168 個事實)+ TeachQuiz 理解 2,062(149 個問題)+ T2VWorldBench 四維 1,384(346 個問題)+ T2VWorldBench 四維 1,384(346 個垃圾單位 評分者 146 個垃圾單位)並排偏好 296 = 6,760 。每個計數都可以根據原始導出重新計算。
VBench 運行。 官方 VBench-Long 程式碼( vbench2_beta_long ,提交 e946a8d )在 5× NVIDIA L4 上,每個用例一個分片,約 6 小時牆;在新日誌上從頭開始固定和複製環境;保留每個單元結果 JSON 和運行每個單元結果 JSON 和運行每個單元。輸入歸一化和 >3.7M 評估演算法:附錄 E 。
B· 工作範例-整個流程的簡要說明
簡報(操作方法場景 1):*「彈出的紙 — 無膠摺紙坐立不安玩具」*,目標 5:00、16:9。與每個簡報一樣,它是一個完全指定的製作文檔,對於所有七個系統都是相同的:具有精確的十六進制調色板的藝術指導、燈光和攝像機語言、具有完整畫外音文本和每個場景的動作註釋的九個場景鏡頭列表,以及一個主提示 - 例如*“…三張顏色編碼的紙(靛藍 6×6 外盒、琥珀色 5×5 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×5 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色 5×54 外盒、琥珀色按鈕彈簧)、建造兩個盒子的共享布林茨折疊…翻蓋塞在相鄰邊緣下方的無膠鎖…」* 完整的資訊有效負載位於簡報中,因此覆蓋失敗可歸因於系統,而不是提示。
其必要的事實清單(以簡短的方式編寫,在生成之前凍結;網站項目以英文呈現)。只有當事實逐字清晰地出現在螢幕上時,它才會被記入——註釋者可以逐幀重播:
- 外箱紙:6×6公分
- 內扣紙:5×5公分
- 彈簧紙:9×4公分
- 無膠承諾:無膠水,無膠帶,任何地方
- 關鍵折疊,名稱:blintz折疊(角到中心)
A TeachQuiz 理解項(觀看後回答;“視頻沒有提供這個”逃逸得分不正確):*“兩個盒子共享的關鍵折疊是什麼?”* — 谷折/blintz 折疊(角到中心)/擠壓折疊。
如何得分。 在這個場景中,TapVid 的兩位評分者都將 5/5 事實記入 並正確回答了 12/12 理解問題 。在這個場景中,相同的項目在該領域的其他地方遇到了真正的失誤——包括折疊名稱問題——這是基準旨在衡量的歧視。
C·統計方法-估計器、種子和獨立重新驗證
Estimators. 二元站(覆蓋、交付):貝葉斯混合邏輯回歸值 ~ system + (1|scene) + (1|item) , TapVid 作為參考。分級站(文字、尺寸):具有註釋器固定效果的場景群集穩健性 OLS。另外还通过留一法信息增益进行传递。 三個獨立的估計器——原始速率、資訊增益、混合邏輯——在兩個幀中產生相同的系統排序。
Uncertainty. 來自場景層級引導程式的 95% CI(對 25 個場景重新取樣,B = 3000,固定種子);顯著性 = 95% 區間排除零;結果報告為間隔重疊的層,絕不是錯誤的精度排名。 VBench:每個維度的 Skillings-Mack 綜合(在 23 個完整場景區塊中,方法差異在 p = 8e-18 到 1e-9 處顯著),事後成對 Wilcoxon 符號秩與 Holm 校正。 Human↔VBench 對齊:Spearman 等級相關,透過 2000× bootstrap、留一系統排除和排列測試(全部為種子)進行壓力測試。
可重複性 - 獨立重新驗證。 所有分析隨機性均已播種,原始資料(完整註釋導出和每個場景 VBench 分數)隨分析一起提供,每個指標在固定依賴項下都有自己的單命令重現腳本(Python 3.14.5 · numpy 2.5.1 · pandas 3.0.3 . · matplotlib 3.11.0 · openpyxl 3.1.5)。在新的環境中獨立重新運行重新生成了所有 55 個提交的結果工件:每個確定性輸出字節相同,所有 15 個數字像素相同,並且變分混合模型列匹配 ≤6e-06 對數賠率 - 任何地方都沒有顯著性判決改變 。
D·可靠性、方法和局限性
評估者設計的穩健性。 該小組是完全交叉的——每個註釋者對每個系統進行評分——因此評估者的嚴格性不會影響系統間的比較。新增註釋器隨機效果移動對比最多 0.16(交付)/0.31(覆蓋)對數賠率,無顯著性翻轉。
每個指標的評估者間協議。 交付:73.6% 原始协议,Gwet AC1 0.59。覆蓋率:67.2%,AC1 0.42 — 註釋器效應是主要的干擾源 (sd 0.98),因此絕對覆蓋率水平對評分者敏感,儘管比較並非如此。內文:一級內 91%,加權 κ 0.27 — 最吵雜的評等。 WorldBench 维度:1 内 79–85%,加权 κ 0.24–0.35。美感偏好:加權 κ 0.07 — 296 次比較的總勝率是有意義的;個人判斷並非如此,這也將正交相關性減弱至零。
Limitations. 交付與此七系統欄位相關,並且在不同欄位的基準運行之間不具有可比性。理解是開卷進行的;0.86 的中位數上限壓縮了系統差異,閉盤運行是最高槓桿銳化。 25 個場景(每個用例 5 個),每個影片有 2 個評估者,綁定每個用例的解析度 — 頂層並未完全分離。報道僅在逐字且清晰的情況下才承認事實。混合對數區間是變分的(反保守的);大的顯著對比是安全的。競技場的星形拓樸不支援競爭對手與競爭對手之間的排名,也不支援絕對的美感評分。 T 分數是相對於現場的便利性,而不是絕對等級。每秒事實頻寬站已定義,但在本輪中未計算。
E·VBench ↔ 人類對齊 — 方法
Instruments. VBench 框架品質是模型的美學品質和成像品質維度的平均值,計算出 quality-when-it-works(失敗的一代被排除,不得分為 0)。人類偏好是與 TapVid 的並列勝率。相關性超過了 六個競爭對手系統 — TapVid 是每次比較的星形拓樸錨點,因此不是標繪點。
| 對齊(VBench 框架品質 ↔ 人類偏好) | Spearmanρ |
|---|---|
| 整體 | +0.89 |
| 留一系統(最壞情況) | +0.87 |
| 專業 | +0.94 |
| 新聞動態 | +0.77 |
| 行銷 | +0.70 |
| 操作方法 | +0.48 |
| 解说员 | −0.33 |
整體標誌經受住了 2000 倍引導重採樣和留一系統; n = 6 個系統限制了形式意義。解釋器是觀眾獎勵動作而不是幀拋光的部分,因此幀品質指標在那裡跟踪不同的線索。每個 VBench 複合材料都是根據每個場景的原始分數重新計算的,並將來源報告與小數點相符。
Run 出處和 >3.7M 計數。 VBench-Long(vbench2_beta_long,提交 e946a8d ;VBench++,IEEE TPAMI 2025)於 2026 年 7 月 13 日至 14 日在 NVIDIA L4 GPU 標籤上運行存在 - 在任何人類比較存在之前。輸入按場景標準化,因此系統不會獲得編碼偽影:720p 上限(從未升級)、統一的 24 fps 幀網格、近乎無損的重新編碼。每個影片有六個維度;其中四個得分*每幀*(每幀 24 個模型前進/秒),運動平滑度為 11.5/秒,動態度為 7.5/秒 - 鏡頭每秒 116 個模型前進。橫跨32,141秒的評分影片:373萬幀級模型評估。對長度修剪版本(上面未計算)的進一步一致性重新檢查驗證了影片長度不會混淆比較:原生修剪增量均 < 0.0025。
F·綜合記分卡-資訊品質與三個軸
场相关 T 分数: 70 = 这七个系统的平均值,每 10 分 = 1 SD。信息质量 = 内容保真度和视觉质量轴的等权平均值。审美偏好是源自领域的,并在信息轴旁边报告,而不是在它们内部——它与它们相反。整體品質(內容+視覺+美感偏好)/3,是指定的資訊密集場景標題。
全部25個場景
| 系統 | 資訊品質 | 95%信賴區間 | 內容 | 視覺 | 審美偏好 |
|---|---|---|---|---|---|
| Fable 5 | 85.4 | [78.3, 92.1] | 82.6 | 88.2 | 52.3 |
| TapVid | 78.2 | [69.3, 86.6] | 77.1 | 79.2 | 61.7 |
| Remotion | 72.3 | [61.5, 82.2] | 76.6 | 68.1 | 69.2 |
| Hyperframes | 71.8 | [59.3, 83.0] | 73.3 | 70.2 | 68.1 |
| Veo | 64.8 | [51.7, 77.0] | 66.0 | 63.6 | 74.6 |
| Seedance | 61.3 | [46.8, 75.1] | 60.3 | 62.2 | 83.1 |
| LTX | 56.3 | [41.8, 70.8] | 54.1 | 58.5 | 81.0 |
信息密集场景(专业、新闻、操作方法、讲解)
| 系統 | 綜合素質(C+V+P)/3 | 內容 | 視覺 | 審美偏好 | 資訊品質 |
|---|---|---|---|---|---|
| TapVid | 75.2 | 83.6 | 80.3 | 61.7 | 82.0 |
| Fable 5 | 75.0 | 82.8 | 88.1 | 54.2 | 85.5 |
| Seedance | 73.5 | 71.7 | 69.7 | 79.1 | 70.7 |
| LTX | 70.0 | 60.2 | 74.8 | 75.1 | 67.5 |
| Remotion | 69.7 | 77.5 | 65.9 | 65.7 | 71.7 |
| Hyperframes | 69.0 | 72.9 | 68.3 | 65.7 | 70.6 |
| Veo | 68.4 | 71.0 | 61.7 | 72.4 | 66.3 |
25 个场景的 Bootstrap CI 广泛重叠:数据支持的层是 Fable 5 · TapVid · Remotion/Hyperframes · 像素三重奏。总体质量 TapVid–Fable 5 差距(75.2 与 75.0)在噪声范围内。此排名對方法(PCA 與軸均值)、可靠性加權以及相關性分組的位置具有穩健性。 TapVid 的美學偏好為 0.5-以競技場的星形拓撲為錨定;它的每個用例的變化存在於競爭對手中。
G · 事實報告-兩個框架
所有 25 個場景 — 螢幕上所需事實的份額,逐字清晰; 95% 引導 CI;混合對數對比。
| 系統 | 覆蓋範圍 | 95%信賴區間 | Δ vs TapVid | 95%信賴區間 | 結果 |
|---|---|---|---|---|---|
| Fable 5 | 0.790 | [0.717, 0.860] | +0.094 | [−0.183, +0.370] | TIE |
| TapVid | 0.773 | [0.699, 0.843] | — | ||
| Remotion | 0.759 | [0.668, 0.845] | −0.166 | [−0.417, +0.085] | TIE |
| Hyperframes | 0.745 | [0.642, 0.842] | −0.199 | [−0.448, +0.050] | TIE |
| Seedance | 0.611 | [0.506, 0.710] | −0.826 | [−1.052, −0.601] | 贏 |
| Veo | 0.596 | [0.494, 0.697] | −0.867 | [−1.091, −0.642] | 贏 |
| LTX | 0.541 | [0.433, 0.658] | −1.179 | [−1.400, −0.958] | 贏 |
資訊密集場景
| 系統 | 覆蓋範圍 | 95%信賴區間 | Δ vs TapVid | 95%信賴區間 | 結果 |
|---|---|---|---|---|---|
| TapVid | 0.836 | [0.773, 0.890] | — | ||
| Fable 5 | 0.792 | [0.710, 0.863] | −0.291 | [−0.601, +0.020] | TIE |
| Remotion | 0.765 | [0.669, 0.857] | −0.520 | [−0.801, −0.239] | 贏 |
| Hyperframes | 0.727 | [0.607, 0.835] | −0.681 | [−0.952, −0.409] | 贏 |
| Seedance | 0.677 | [0.578, 0.770] | −0.922 | [−1.182, −0.662] | 贏 |
| Veo | 0.601 | [0.497, 0.714] | −1.213 | [−1.464, −0.963] | 贏 |
| LTX | 0.545 | [0.418, 0.671] | −1.553 | [−1.798, −1.307] | 贏 |
覆蓋率 ↔ 投放:173 個影片中 Pearson r = 0.70;合併 OLS 給出 P(理解|螢幕上) = 0.96 和螢幕外 0.36 的地板;混合 Logit 一致 (0.945 / 0.30)。覆蓋率的絕對水準對評分者敏感(參見 D);系統間比較則不然。
H·TeachQuiz 訊息傳遞 — 兩種框架
所有 25 個場景 — 典型場景/問題的原始理解正確率、混合對數預測 P(正確) 和對比。
| 系統 | 原始率 | 預測P | Δ vs TapVid | 95%信賴區間 | 結果 |
|---|---|---|---|---|---|
| Fable 5 | 0.821 | 0.868 | +0.243 | [−0.091, +0.576] | TIE |
| Remotion | 0.812 | 0.857 | +0.147 | [−0.167, +0.461] | TIE |
| TapVid | 0.795 | 0.838 | — | ||
| Hyperframes | 0.789 | 0.834 | −0.028 | [−0.330, +0.274] | TIE |
| Veo | 0.785 | 0.830 | −0.052 | [−0.353, +0.249] | TIE |
| LTX | 0.715 | 0.756 | −0.509 | [−0.786, −0.233] | 贏 |
| Seedance | 0.691 | 0.730 | −0.647 | [−0.918, −0.377] | 贏 |
資訊密集場景
| 系統 | 原始率 | Δ vs TapVid | 95%信賴區間 | 結果 |
|---|---|---|---|---|
| Fable 5 | 0.846 | +0.056 | [−0.342, +0.453] | TIE |
| TapVid | 0.845 | — | ||
| Veo | 0.840 | +0.005 | [−0.368, +0.378] | TIE |
| Remotion | 0.832 | −0.067 | [−0.433, +0.299] | TIE |
| Hyperframes | 0.790 | −0.393 | [−0.731, −0.054] | 贏 |
| Seedance | 0.786 | −0.423 | [−0.759, −0.087] | 贏 |
| LTX | 0.752 | −0.650 | [−0.971, −0.329] | 贏 |
交付是相對於這個七系統字段(留一增益/現場基線logit);政府採取開放式管理,將差異壓縮至 0.86 的中位數上限。三個估計器(原始、增益 D、混合 Logit)在兩個框架中的順序達成一致。
I·T2VTextBench文字精準度和T2VWorldBench尺寸
T2VTextBench 文本准确度 — [0,1] 上的四级等级;集群稳健对比与 TapVid。 * = 95% CI 排除零。
| 系統 | 全部 25 個 | 95%信賴區間 | 資訊密集 | 95%信賴區間 | Δ全25 |
|---|---|---|---|---|---|
| Fable 5 | 0.783 | [0.714, 0.850] | 0.750 | [0.681, 0.825] | +0.062 |
| TapVid | 0.740 | [0.660, 0.820] | 0.769 | [0.675, 0.856] | — |
| Hyperframes | 0.700 | [0.615, 0.785] | 0.706 | [0.613, 0.794] | −0.009 |
| Remotion | 0.695 | [0.610, 0.785] | 0.688 | [0.594, 0.781] | −0.050 |
| Seedance | 0.640 | [0.535, 0.740] | 0.700 | [0.594, 0.806] | −0.087 |
| Veo | 0.630 | [0.530, 0.730] | 0.650 | [0.531, 0.762] | −0.090 |
| LTX | 0.580 | [0.500, 0.660] | 0.619 | [0.537, 0.694] | −0.145* |
T2VWorldBench,所有 25 個場景 — 每個維度和紙張複合材料的平均等級。 * = 與 TapVid(群集穩健性 OLS)相比顯著。
| 系統 | 品質 | 現實主義 | 相關性 | 一致性 | 複合材料 |
|---|---|---|---|---|---|
| Fable 5 | 0.900* | 0.909 | 0.891 | 0.909 | 0.902* |
| TapVid | 0.860 | 0.880 | 0.844 | 0.872 | 0.864 |
| Remotion | 0.800 | 0.860 | 0.860 | 0.824 | 0.836 |
| Hyperframes | 0.812 | 0.852 | 0.816 | 0.844 | 0.831 |
| Veo | 0.800 | 0.804 | 0.808 | 0.824 | 0.809 |
| Seedance | 0.808 | 0.808 | 0.772* | 0.796* | 0.796* |
| LTX | 0.792 | 0.784* | 0.688* | 0.792* | 0.764* |
此複合材料在內部有效(Cronbach α = 0.91),但折疊了一個面向內容的軸:相關性與交付/覆蓋率(+0.77)的相關性大於其同級視覺維度(0.61-0.66)的相關性。資訊密集框架:TapVid 在每個維度上都保持第二;只有品質和綜合性能與 Fable 5 的差距仍然很大。
J·美感偏好(競技場式)-兩個框架,兩個閱讀
星形拓樸:的每一次比較都是TapVid與同一簡介上的一個競爭對手的比較(296次比較)。勝率將平局視為一半; TapVid 的非損失計數平局;兩者均已報告。根據二項式混合 logits 與 0.5 無偏好線得出的結論。
全部25個場景
| 與 | 勝率 | 95%信賴區間 | 無損 | 95%信賴區間 | 判決 |
|---|---|---|---|---|---|
| Fable 5 | 0.587 | [0.482, 0.683] | 0.696 | [0.577, 0.808] | TapVid 不输* |
| Hyperframes | 0.440 | [0.347, 0.531] | 0.560 | [0.458, 0.667] | 拋擲 |
| Remotion | 0.430 | [0.338, 0.519] | 0.540 | [0.433, 0.643] | 拋擲 |
| Veo | 0.380 | [0.297, 0.464] | 0.480 | [0.389, 0.571] | 拋擲 |
| LTX | 0.320 | [0.217, 0.417] | 0.380 | [0.267, 0.500] | TapVid 输* |
| Seedance | 0.300 | [0.206, 0.393] | 0.400 | [0.286, 0.500] | TapVid 输* |
| 整體 | 0.407 | [0.35, 0.47] | 0.507 | [0.44, 0.57] | 不如该领域* |
資訊密集情境 — 總勝率 0.432 [0.37, 0.50],非損失 0.530:平價。重大的非損失赤字消失了;在嚴格的決定性比較中,只有 Seedance 仍然是顯著首選。
| 與 | 勝率 | 95%信賴區間 | 無損 | 95%信賴區間 |
|---|---|---|---|---|
| Fable 5 | 0.569 | [0.450, 0.692] | 0.667 | [0.542, 0.800] |
| Remotion | 0.463 | [0.354, 0.568] | 0.575 | [0.458, 0.692] |
| Hyperframes | 0.463 | [0.361, 0.563] | 0.600 | [0.500, 0.714] |
| Veo | 0.400 | [0.304, 0.500] | 0.500 | [0.385, 0.607] |
| LTX | 0.375 | [0.250, 0.500] | 0.425 | [0.292, 0.545] |
| Seedance | 0.338 | [0.225, 0.450] | 0.425 | [0.286, 0.567] |
偏好在經驗上與資訊指標正交:將 TapVid 在每個指標上的每個視訊優勢與競技場結果相關聯,得出 -0.22 到 -0.01(n = 148 個單元格)——全部為負或接近零。不損失是有利的讀數(20%的比較是平局);出於這個原因,兩者都被顯示。
K · 每個用例的排名 - TapVid 獲勝和失敗的位置
每個用例相對於 TapVid 都有顯著的勝利/損失(95% 間隔不包括零)。細胞列出競爭對手; “—”=無。
| 使用案例 | 覆蓋範圍:TapVid 節拍 | 輸給 | 发货:TapVid 节拍 | 輸給 |
|---|---|---|---|---|
| 專業 | Fable 5、Hyperframes、Veo、LTX | — | Fable 5、LTX | Seedance |
| 新聞動態 | Remotion、Veo、LTX、Seedance | — | Remotion、LTX、Seedance | — |
| 操作方法 | Remotion、Hyperframes、Veo、LTX | — | Veo | — |
| 解说员 | LTX、Seedance | Fable 5 | Seedance | Fable 5 |
| 行銷 | Seedance | Fable 5、Remotion、Hyperframes | Seedance | Fable 5、Remotion、Hyperframes |
沒有一個系統能在所有地方獲勝:Seedance 在專業交付方面領先,但在行銷方面卻崩潰(P < 0.30);Veo 追平新聞傳遞領先地位,但在 How-To 領域表現最差。按用例劃分的 TapVid 競技場勝率:專業 0.450、新聞 0.433、解釋者 0.429、操作方法 0.417、行銷 0.308。 TapVid 按用例劃分的綜合資訊品質:新聞 87、操作方法 89、解釋者 81、專業 71、行銷 63。
试试TapVid
將提供的資源和批准的副本轉變為可審查的解說視訊工作流程。 探索TapVid。
参考文献和引用
支援的評估方法包括T2VTextBench、T2VWorldBench和文本到視訊人類評估協議。
Recommended citation (APA): Law, D. (2026, September 6). AI video benchmark: Accuracy vs aesthetics (Version 1.0). TapVid Research. https://tapvid.ai/blog/information-dense-ai-video-benchmark
@techreport{law2026aiVideoBenchmark,
  author = {Derek Law},
  title = {AI Video Benchmark: Accuracy vs Aesthetics},
  institution = {TapVid Research},
  year = {2026},
  month = {September},
  url = {https://tapvid.ai/blog/information-dense-ai-video-benchmark},
  note = {Version 1.0; July 2026 benchmark run}
}