
TL;DR
讓 talking head 影片更吸引人的關鍵,是讓說話者繼續充當信任錨點,只在畫面能夠回答人臉本身無法回答的問題時加入視覺。用標注量化主張,用結構化版式呈現清單,用圖解說明關係,用相關 B-roll 展示具體語境。這四類任務來自口述語義單元中的資訊,而不是固定剪輯節奏。這是一套決策框架,不是每隔幾秒就必須換畫面的規則。如果視覺不能讓口述觀點更容易核驗、組織、理解或想象,就不要加入。
Talking head 影片之所以有效,是因為真人能夠傳遞幻燈片無法承載的語氣、信念和細微差別。當畫面不再參與解釋時,這種形式就會變得乏味。這是資訊問題,不只是缺少運動。
01
什麼讓 Talking Head 影片真正有效?
Talking head 是一種面對鏡頭或訪談式的影片,由說話者承擔大部分敘事。說話者可能在講流程、解釋觀點、評測產品、回答問題或講故事。鏡頭可以包含頭肩之外的畫面,但定義特徵相同:人是資訊的主要來源。
真人讓這種形式具備三項重要特性。
第一,觀眾可以讀懂表達。停頓、表情變化或重音轉換都能說明什麼最重要。第二,說話者讓資訊有了明確歸屬,觀眾知道是誰提出主張,並能結合語境判斷。第三,製作可以保持相對簡單,一個構圖良好的錄制就能承載完整課程或產品講解。
這些優勢帶來一條實用剪輯原則:不要把出鏡者當成等待被遮蓋的空白。說話者的臉往往是螢幕上資訊量最大的視覺,尤其是在個人觀點、敏感內容或可信度依賴表達的時刻。
因此,輔助視覺應在說話者周圍承擔證據和解釋作用。說到價格時顯示價格;三部分框架要變成可見的三段結構;因果關係要變成簡單圖解;提到實體地點、介面或動作時,可以加入相關 B-roll。每一種視覺都有明確任務。
02
為什麼 Talking Head 影片會開始顯得無聊
靜態畫面並不天然無聊。一個清楚且情感具體的故事,幾乎不剪也能吸引注意力。真正的問題始於資訊已經變化,畫面卻沒有變化。
想象出鏡者說:"我們把流程從六步縮減到三步:先取消審批循環,再標準化 brief,最後只審核一版草稿。"這句話包含比較、數字和三段順序。如果畫面完全不變,觀眾必須一邊記住整套結構,一邊繼續聽下一句話。
再想象相反的錯誤:每個名詞都觸發素材庫畫面,每句話都縮放,大號字幕重復整段旁白。畫面一直在動,但觀眾仍要判斷哪個元素真正重要。運動增加了,清晰度反而下降。
薄弱剪輯通常落入四種模式:
- 沒有視覺支撐的抽象表達。 說話者提到系統、關係或流程,但觀眾看不到。
- 被隱藏的結構。 清單、對比、順序或層級只被說出來,卻沒有在畫面中組織。
- 未經核驗的具體資訊。 數字、引用、介面狀態或結果沒有任何可見依據。
- 裝飾性打斷。 效果改變了畫面,卻沒有增加意義,反而和說話者爭奪注意力。
這比"影片需要更多 B-roll"更能定位問題。請找出畫面從哪裡開始無法幫助觀眾處理資訊。那個位置只是視覺層的候選點,還不是必須添加的命令。
03
剪輯前先標記轉錄稿
轉錄稿是把完成的錄制變成可辯護視覺計劃的最快路徑。你不需要詳細分鏡,只需要一張語義單元地圖,標出觀眾會產生具體視覺問題的句子。
先完整閱讀一次轉錄稿,不要急著選效果。只標記包含以下信號的口述語義單元:
| 語義單元類型 | 腳本中的信號 | 觀眾問題 | 可能的視覺任務 |
|---|---|---|---|
| 數量 | 數字、百分比、日期、價格、比較 | "準確數值或差異是多少?" | 用標注或緊湊圖表量化 |
| 結構 | 清單、順序、框架、層級 | "這些部分如何組織?" | 用卡片、步驟或帶標籤版式呈現結構 |
| 關係 | 因果、流程、依賴、對比、反饋循環 | "這些觀點如何連接?" | 用圖解或並排比較說明 |
| 具體指代 | 產品、地點、物件、螢幕、動作、事件 | "它實際是什麼樣子?" | 加入相關 B-roll、螢幕捕捉或來源圖片 |
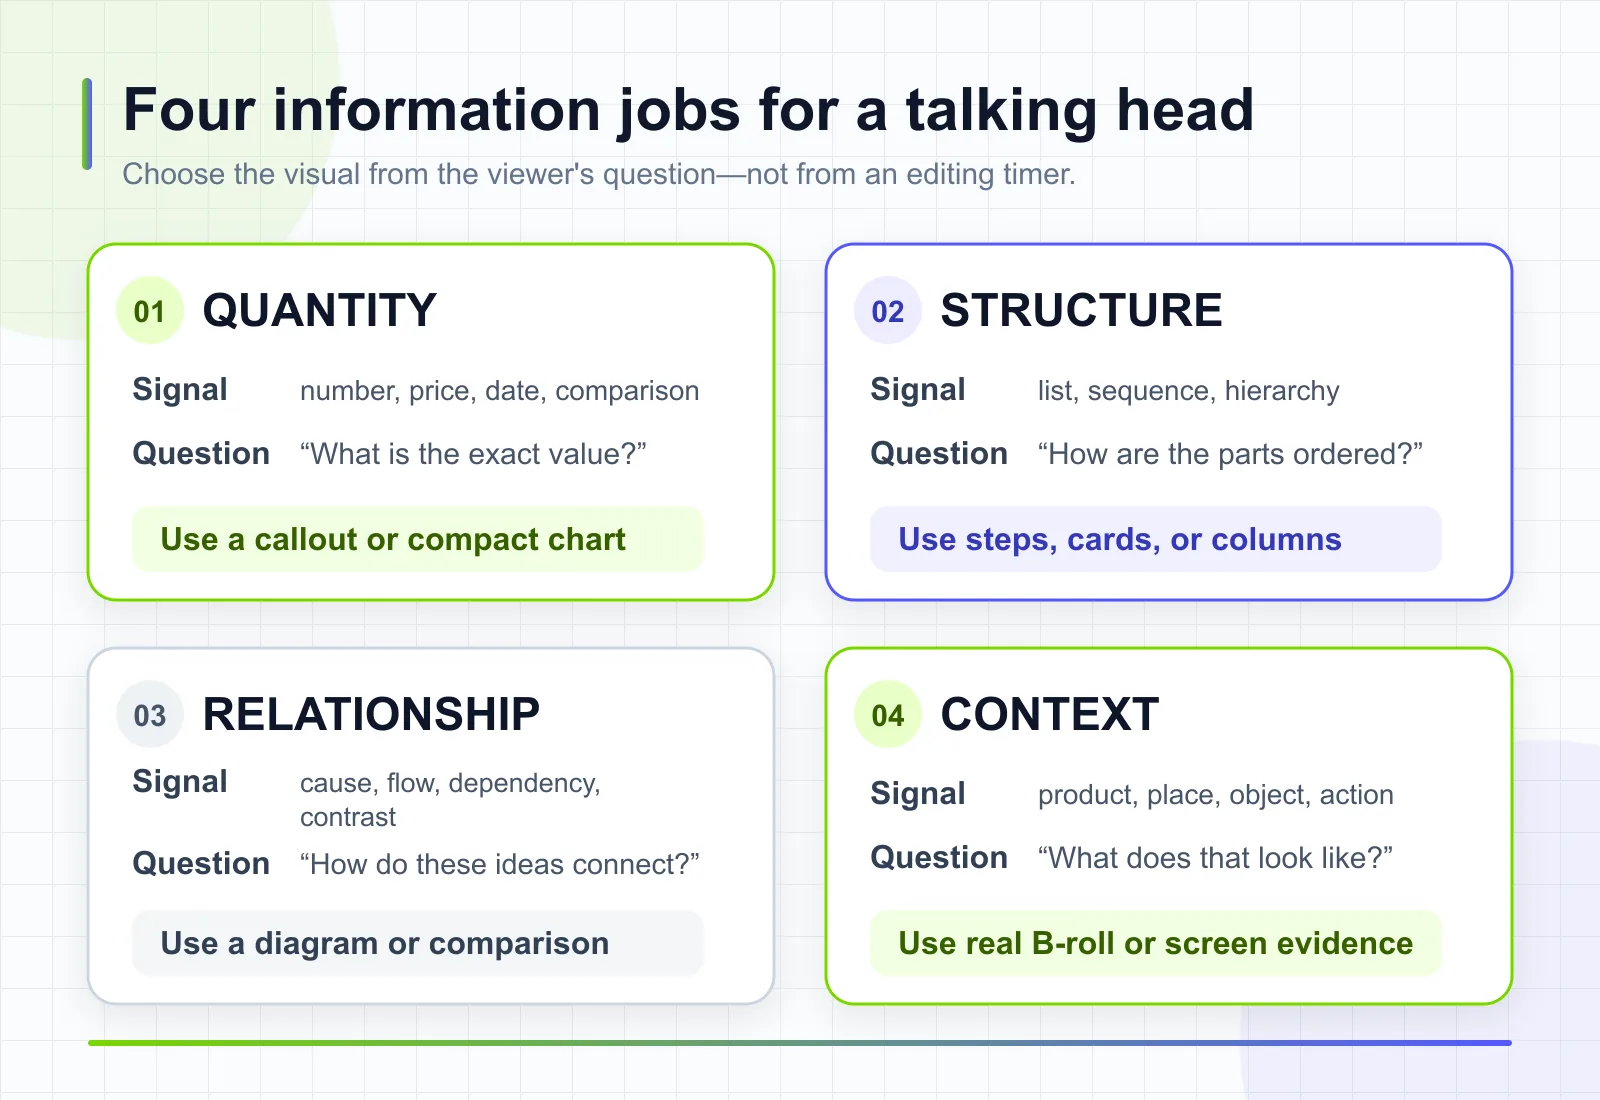
*從觀眾問題開始。數量需要準確數值,結構需要可見順序,關係需要連接,具體指代需要真實語境。視覺任務決定形式,而不是計時器。*
不要標記每一句。比如"發佈前我很緊張",讓說話者留在畫面中可能更有效,因為人臉承載了意義;而"發佈流程有三道審批"包含結構,可見的三步版式能讓它更清楚。
然後為每個被標記的語義單元寫一份簡短視覺 brief。有效 brief 要寫明口述原句、觀眾問題、最低必要可見信號和返回點。例如:
口述原句:"流程有三項檢查:資訊、證據和交付。"觀眾問題:"是哪三項?"最低信號:按同一順序顯示三個標籤。返回點:第三項結束後回到說話者。
這份 brief 能避免編輯或 AI 工具解決錯誤的問題。"加點吸引人的東西"會邀請裝飾;"按順序顯示三項檢查,同時保留說話者"則定義了可以審核的結果。
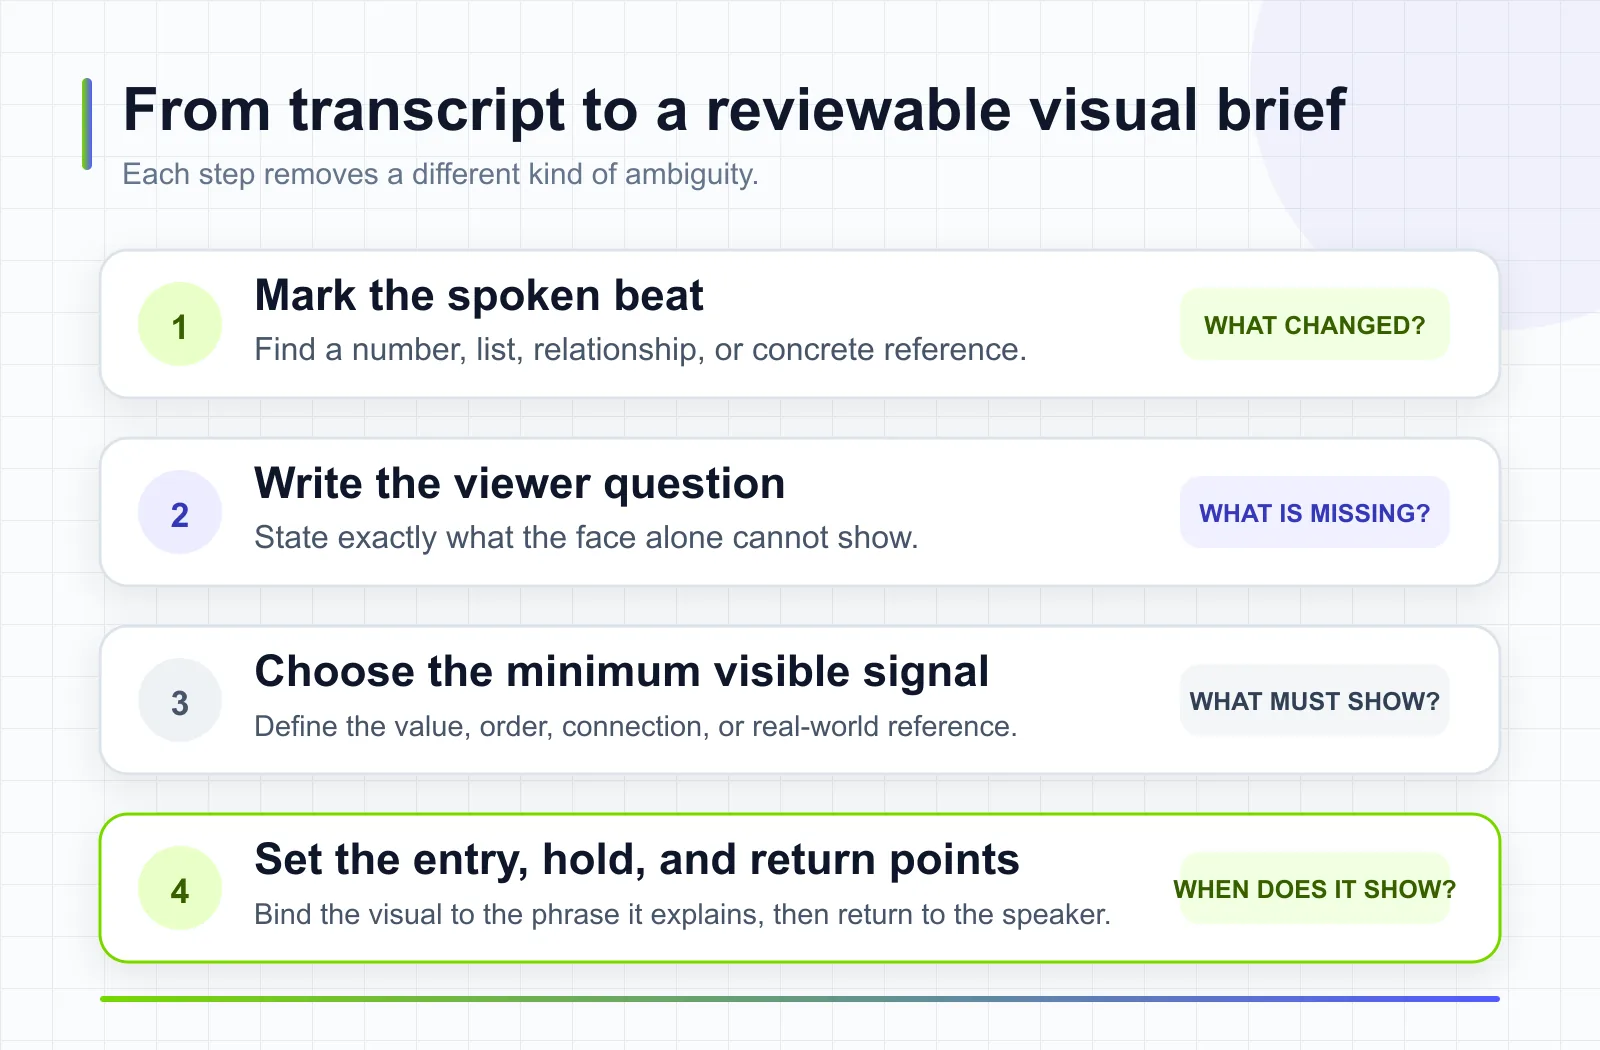
*可審核的視覺 brief 記錄四項決定:口述語義單元、觀眾問題、最低必要可見信號,以及準確的進入、停留和返回點。每項決定都會消除一種不同的模糊性。*
04
為每個口述語義單元選擇正確視覺
形式應跟隨資訊任務。先使用能讓語義單元變清楚的最小視覺,只有當簡單形式無法承載意義時才增加複雜度。
準確事實用標注。 數字、日期、名稱或短比較通常需要簡潔標籤,而不是全屏動畫。保持數值可讀,並停留足夠時間。如果數字屬於證據,請在主張附近或周邊內容中給出來源。樣式無法把沒有依據的數字變成證明。
清單或框架用結構化版式。 卡片、列、編號步驟和進度狀態能讓集合內部關係變得可見。保持說話者的順序。如果出鏡者說"第一、第二、第三",不能僅因為更有動感就先顯示第三項。
抽象關係用圖解。 當觀眾需要看到方向、依賴、分組或隨時間變化時,圖解才有必要。只保留當前口述單元需要的節點和連接。一個只出現兩秒的複雜圖解不是解釋,而是視覺噪音。
具體語境用 B-roll。 相關 B-roll 展示正在討論的物件、動作、介面或環境,並應縮小歧義。如果說話者說"檢查移動端結賬頁",對應介面捕捉會有幫助;泛化的敲鍵盤素材通常沒有。
無障礙和語言支持用字幕。 字幕不只是留存效果。W3C Web Accessibility Initiative 將字幕定義為與語音及理解媒體所需非語音音頻同步的文本,並指出包含必要音頻的預錄影片需要字幕來滿足無障礙要求。自動字幕應人工核對,因為識別錯誤會改變含義。設計過的關鍵詞標注可以和字幕共存,但不能遮擋字幕,也不能假裝取代完整字幕軌。
主張依賴介面時用螢幕證據。 如果你說某個設置存在,就展示真實狀態或連結到當前官方文檔。只裁切到足以讓狀態可讀的範圍。保留理解證據所需的標識,同時移除私密帳號資料。
一句話可能包含不止一種語義單元。不要同時疊加所有可能的視覺層。先選擇對理解影響最大的任務,再判斷句子後半段是否真的需要第二個視覺。
05
讓說話者保持可見,同時避免畫面靜止
版式在說話者周圍變化時,人仍然可以留在畫面里。並排構圖、畫中畫或臨時下方資訊區,都能為證據騰出空間而不打斷連續性。關鍵是視覺層級。
在任何時刻,決定觀眾應該首先看什麼。在個人索賠期間,那通常是一張臉。在三步解釋期間,結構化列表可能會成為主要列表,而演講者在較小的尺寸下保持可見性。在螢幕演示期間,介面可能會接管,操作完成後揚聲器會返回。
用進入和退出時間表達這種焦點轉移。相關短語開始時讓視覺進入,貫穿它所解釋的短語,並在旁白轉向時移除。過早出現會破壞揭示;過晚出現會迫使觀眾一邊處理上一句,一邊聽新內容。
不要用速度取代資訊層級。快速剪接可以製造活力,卻也可能刪掉觀眾需要仔細查看的關鍵影格。成果、引言或圖解所需的停留時間,可能比裝飾性轉場更長。讓資訊本身決定持續時間。
字幕同樣需要克制。大號動畫詞可以強調關鍵詞,但用另一套競爭性樣式重復整段旁白,往往會形成兩層閱讀任務。無障礙字幕樣式應保持一致,只有當強調文字提供獨立信號時才單獨使用,例如比較中的數字。
06
實用的 Talking Head 影片剪輯工作流
你可以在傳統編輯器、基於轉錄稿的編輯器,或能添加同步視覺層的工具中使用這套流程。審核邏輯不變。
1. 添加視覺前先鎖定資訊。 完整觀看一次來源片段,確認表演表達了預期觀點且音頻可用。視覺層無法修復缺失論證、事實錯誤或含糊結論。
2. 只清理所選工作流真正支持的內容。 在主編輯器中刪除不可用錯誤或選擇正確 take。如果下一工具保留原影片和音頻,不要假設它還會刪除停頓、改變表演、調色或修復聲音。把這些任務留在真正支持它們的剪輯階段。
3. 生成或審核轉錄稿。 在把轉錄稿當成計劃前,先修正姓名、數字、產品術語和否定詞。錯誤轉錄會產生錯誤標注和誤導性視覺。
4. 標記數量、結構、關係和語境語義單元。 使用四類任務表。情緒、證言和連接性語句通常不要標記,除非視覺對理解確實必要。
5. 為每個選中語義單元寫一份視覺 brief。 寫明必須可見的內容和必須保持真實的內容。比較要指定兩邊數值;清單要保持順序;圖解要指定節點和方向;B-roll 要寫具體指代,不要只寫氛圍。
6. 製作第一版視覺層。 為每個選中語義單元加入最低必要視覺。當表達仍然重要時保留說話者。先不要潤色轉場。
7. 用三種方式審核。 第一遍帶聲音觀看,檢查同步;第二遍靜音,檢查每個新增視覺是否仍傳達預期信號且沒有編造新主張;第三遍在最小目標尺寸查看,檢查文字、連接線和介面細節是否可讀。
*三輪審核檢查不同失敗模式:聲音暴露時間錯誤,靜音播放暴露沒有依據的視覺主張,最小交付尺寸暴露不可讀標籤或關係。*
8. 刪除沒有通過任務測試的視覺。 如果視覺只是重復旁白卻沒有澄清、引入無依據主張、出現太晚、消失太早、遮擋字幕,或只在表面關鍵詞層面相關,它就沒有通過。
9. 檢查完整體驗。 在目標寬高比中核驗音頻、字幕、節奏、版式和導出結果。視覺計劃可能語義正確,卻因為手機上的文字不可讀而失敗。
工作時維護一份簡單審核台賬。對每個選中語義單元記錄原句、時間碼、視覺任務、所選素材、通過或失敗結果以及修正內容。這會把"更有衝擊力一點"之類的主觀反饋變成可執行備注。編輯可以判斷問題是時間錯誤、證據薄弱、文字不可讀還是視覺不匹配。台賬也讓後續修訂更安全,因為你可以只替換一個失敗語義單元,而不必重做整個視覺計劃。
對於持續製作影片的內容團隊、代理商或品牌,同一台賬也讓修訂週期更容易審計。審核者可以定位具體場景、來源項目和變化過的視覺決定,而不是重做整支影片,或只給出含糊反饋導致下一輪繼續猜測。
多人審核時,請讓所有人圍繞同一組任務發表評論。有人可能不同意顏色或轉場,但所有人都能回答數字是否正確、清單是否完整、圖解是否匹配關係,以及 B-roll 是否真的展示了被提到的對象。先解決意義和可讀性,再單獨處理樣式偏好。
TapVid 是適用於這類工作流的 Explainer Video Engine。對於現有片段,TapVid 的 talking-head 工作流把錄制、原始音頻、已批准文案和提供的素材視為事實來源,並在其周圍加入同步標注、圖解、字幕、版式和相關 B-roll。因此它適合本文所述的視覺層階段。邊界同樣重要:它不替代專業調色、音頻修復、素材剪輯或更好 take 的選擇,也不應被描述成代寫或取代創作者的資訊。
如果你正在建立從拍攝前就開始的更完整製作流程,可以參考 TapVid 的分步 AI 影片工作流。本文剪輯建議仍假設已經存在一段有價值的 talking-head 錄制。下面的 TapVid 認證實測使用固定 prompt,而不是上傳來源素材,因為帳號中沒有獲得公開使用權的 talking-head 片段。因此,它是對生成視覺主張的 prompt-to-video 審核,不是來源素材保真度的證明。
07
什麼時候不該加入更多視覺
更多視覺資訊可能削弱 talking head 最值得觀看的時刻。當人臉本身屬於證據時,應讓說話者保持主體。
個人故事往往依賴表情和節奏。用素材庫畫面遮住說話者,會把具體回憶變得泛化。證言同樣需要克制。如果觀眾正在判斷一個人是否真誠和自在,全屏疊層會移除他們需要的資訊。
敏感陳述也可能需要同樣處理。道歉、艱難承認或細緻限定不應自動觸發畫面變化。讓觀眾看到表達;只有在理解主張確實需要時,才加入來源或簡短標籤。
當素材弱於口述指代時,也不要加入。泛化辦公室 B-roll 無法解釋具體審批工作流;虛構儀表板不能證明真實結果;文字不可讀的圖解不能澄清關係。這三種情況下,停留在說話者身上反而更誠實。
使用這份快速排除測試:
- 視覺是否回答了一個明確的觀眾問題?
- 它是否保持了口述原句的含義和順序?
- 觀眾能否在目標尺寸讀懂或識別關鍵信號?
- 該視覺是否允許公開使用,並且不含私密資料?
- 它是否避免提出比旁白證據更強的主張?
只要任一必要問題的答案是否定的,就應修改素材或將其刪除。
08
Talking Head、Avatar 與無臉 Explainer 的區別
這些形式解決不同製作問題。選擇時應看什麼承擔信任、什麼必須被展示,而不是哪種樣式看起來更自動化。
| 形式 | 最適合的情況 | 主要輸入 | 信任錨點 | 常見限制 |
|---|---|---|---|---|
| 真人 talking head | 說話者的身份、經驗、觀點或表達很重要 | 錄制的真人表演 | 真人說話者 | 必須謹慎地圍繞表演增加視覺變化 |
| AI avatar 主播 | 一致性、本地化或腳本交付比特定真人錄制更重要 | 腳本、avatar 和聲音選擇 | 所選主播身份和製作系統 | 因為沒有需要保留的原始表演,所以無法保留真人來源表演的細微差別 |
| 無臉 explainer | 機制、產品、流程或證據應成為主體 | 腳本、螢幕素材、圖解、影片或其他資產 | 解釋及其證據 | 當作者身份或親身經歷很重要時,可能顯得不夠個人化 |
如果創作者已經有一段有力的真人錄制,不應僅因為原始畫面顯得靜態就改用 avatar。先判斷現有表演是否有價值;有價值就增強其周圍的解釋層。如果不需要來源表演,目標是可重復的腳本交付,avatar 可能更合適。如果觀眾必須檢查工作流、介面或機制,無臉 explainer 可以給主題更多空間。
本文支持第一條路徑,不對 avatar 產品排名,也不主張任何一種形式普遍更好。
09
交付前的準確性審核發現了什麼
在這套工作流里,準確性是一項審核標準,而不是對每一幀生成結果都正確的假設。已批准腳本、來源素材,以及兩者之間預期的對應關係,決定場景可以說什麼、展示什麼。任何未出現在這些來源中的生成數字、坐標軸或評價性主張,都必須在交付前被拒絕。
為了在看到結果後不改變要求,我在已認證的 TapVid 產品應用中運行了一條固定 prompt。這個 30 秒、16:9 的請求包含四類視覺任務:8–12 秒節奏規則、orient-prove-reset 結構、把圖解放在它所解釋的句子旁邊,以及當說話者提到產品時展示介面。它還要求克制的運動、可讀字幕、清楚的前後對照,以及不使用裝飾性素材庫畫面。
這次運行沒有上傳 talking-head 錄制,而是圍繞帶標籤的說話者代理生成動態圖形。因此,它不能支持保留真實來源片段、聲音、表情或機位的主張。但它仍能回答一個更窄的問題:當 prompt 要求關係視覺時,最終畫面里出現了哪些主張?
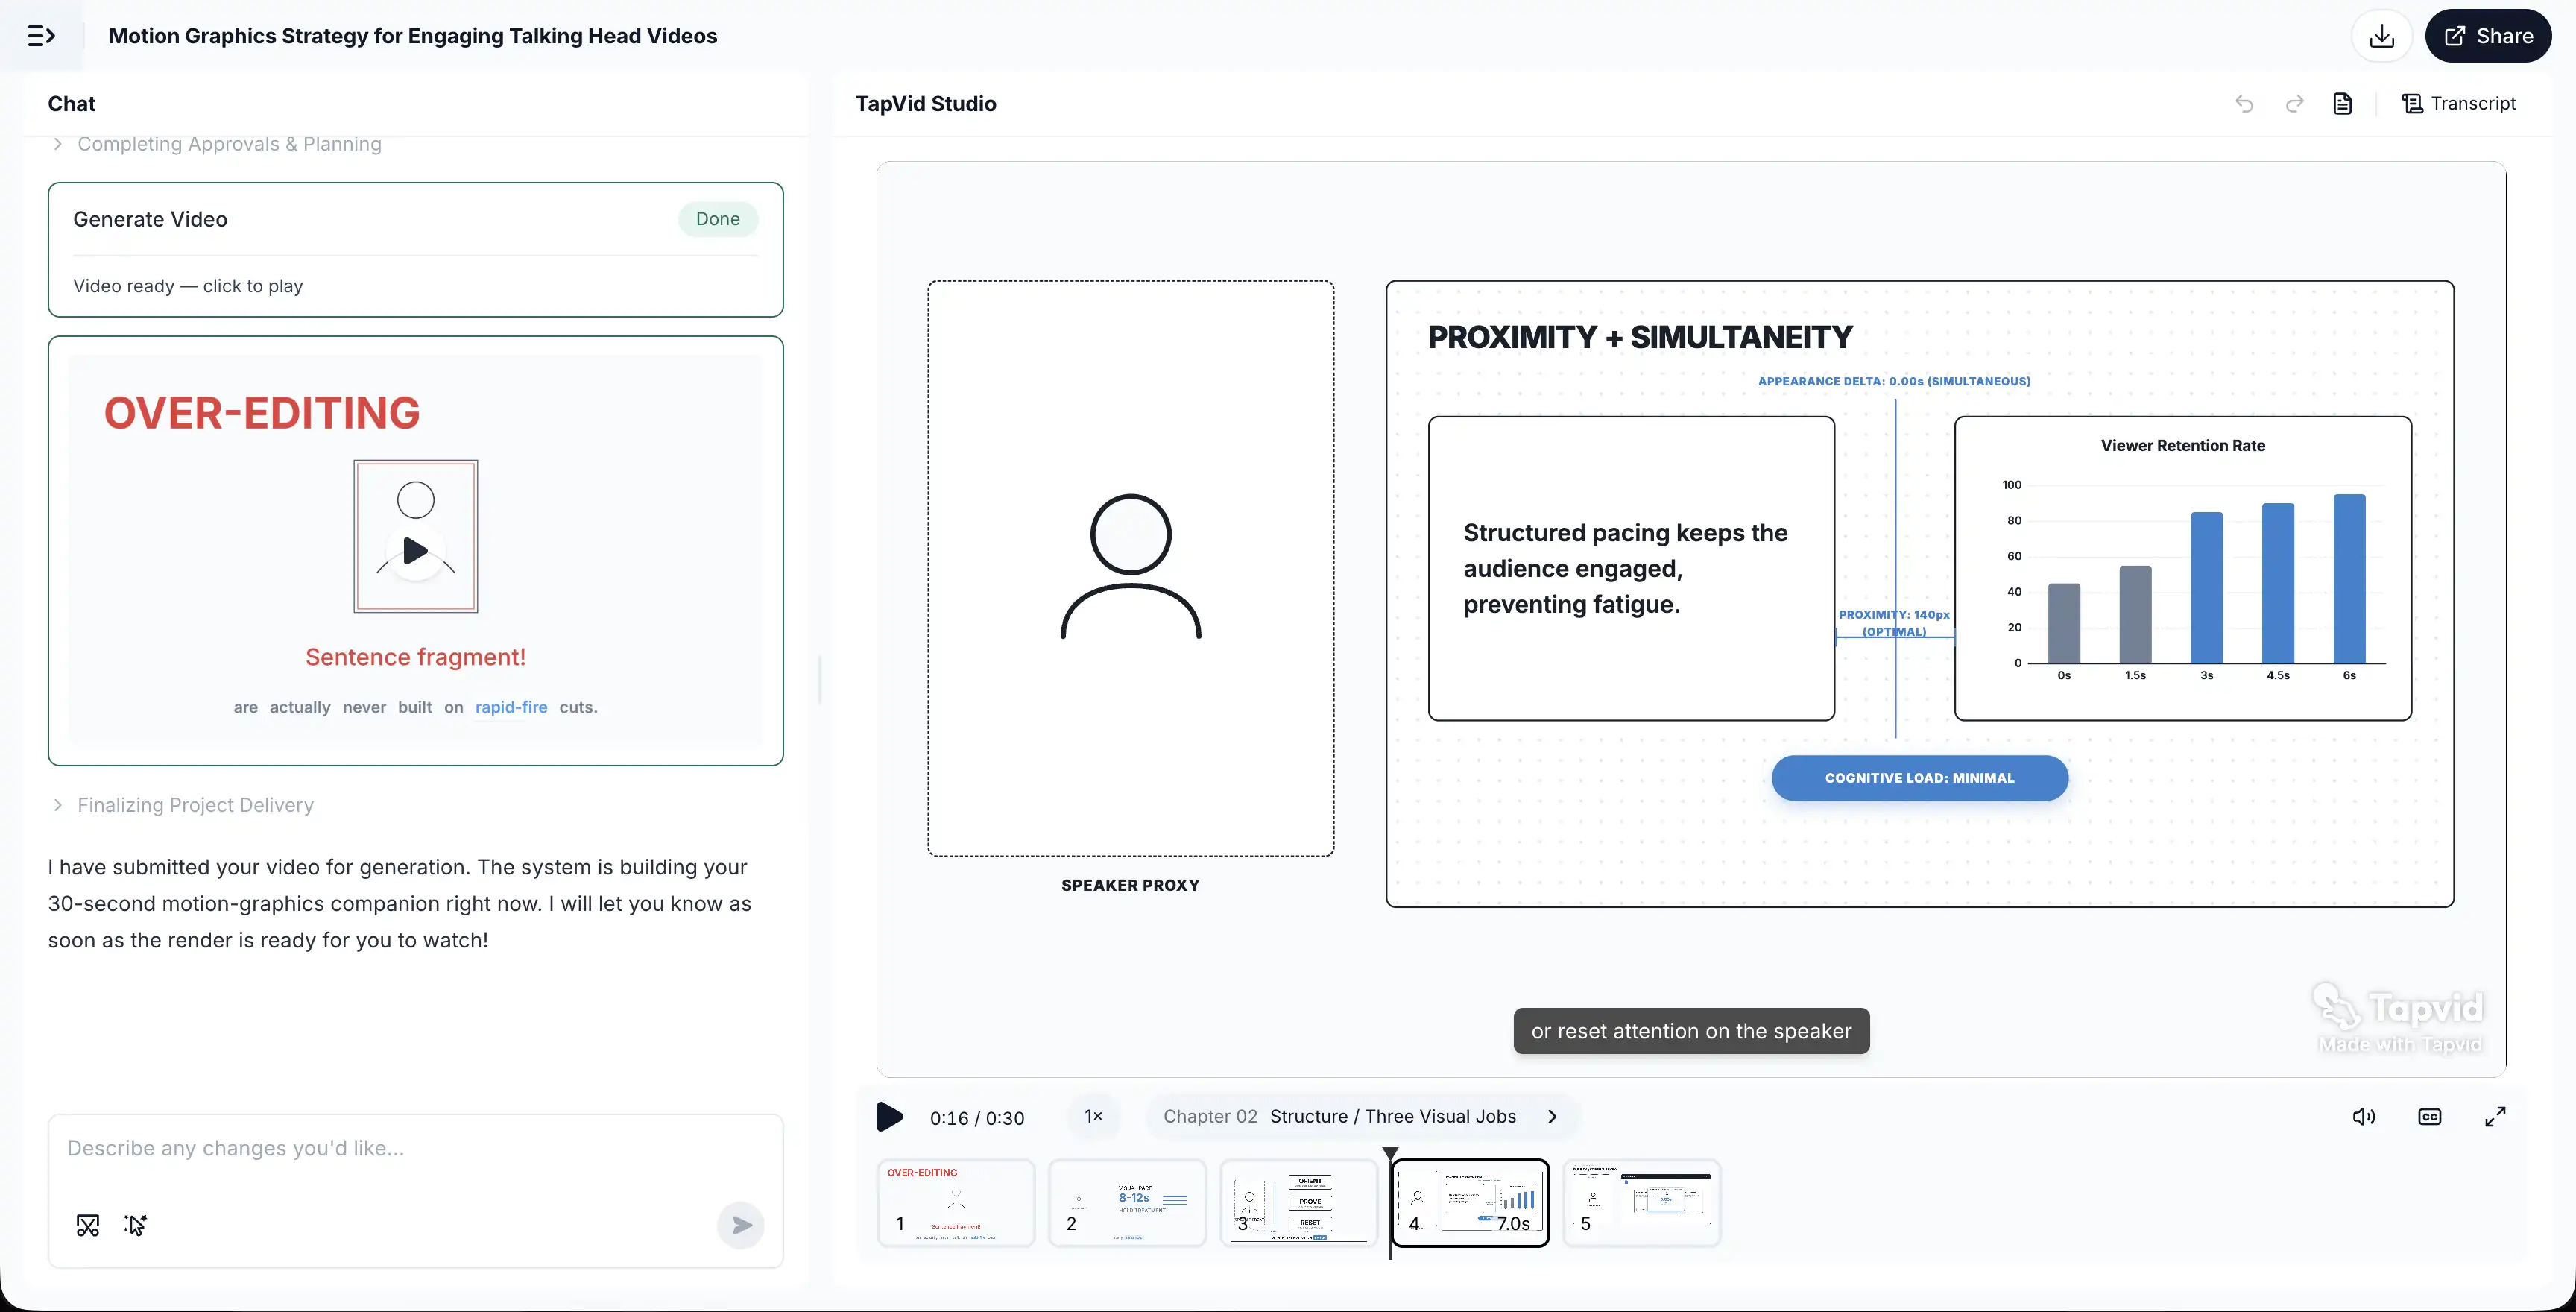
第一眼看,結果遵循了要求的構圖:左側保留說話者代理,解釋材料放在旁邊,場景圍繞 proximity 和 simultaneity 標注。問題出現在檢查材料內部主張時。畫面新增了五柱的"Viewer Retention Rate"圖表,把 140 像素間距標為"OPTIMAL",並宣稱"COGNITIVE LOAD: MINIMAL",卻沒有顯示來源、測量方法或底層資料。
這會改變對場景的判斷。它通過版式檢查,因為關係材料確實放在說話者旁邊;但它沒有通過靜音真實性檢查,因為視覺提出了比 prompt 和證據更強的主張。同步不能讓圖表變成事實,精緻標籤也不能把虛構閾值變成測量結果。
正確做法是拒絕沒有依據的量化層,並修改或重新運行該場景,而不是因為構圖精緻就接受它。
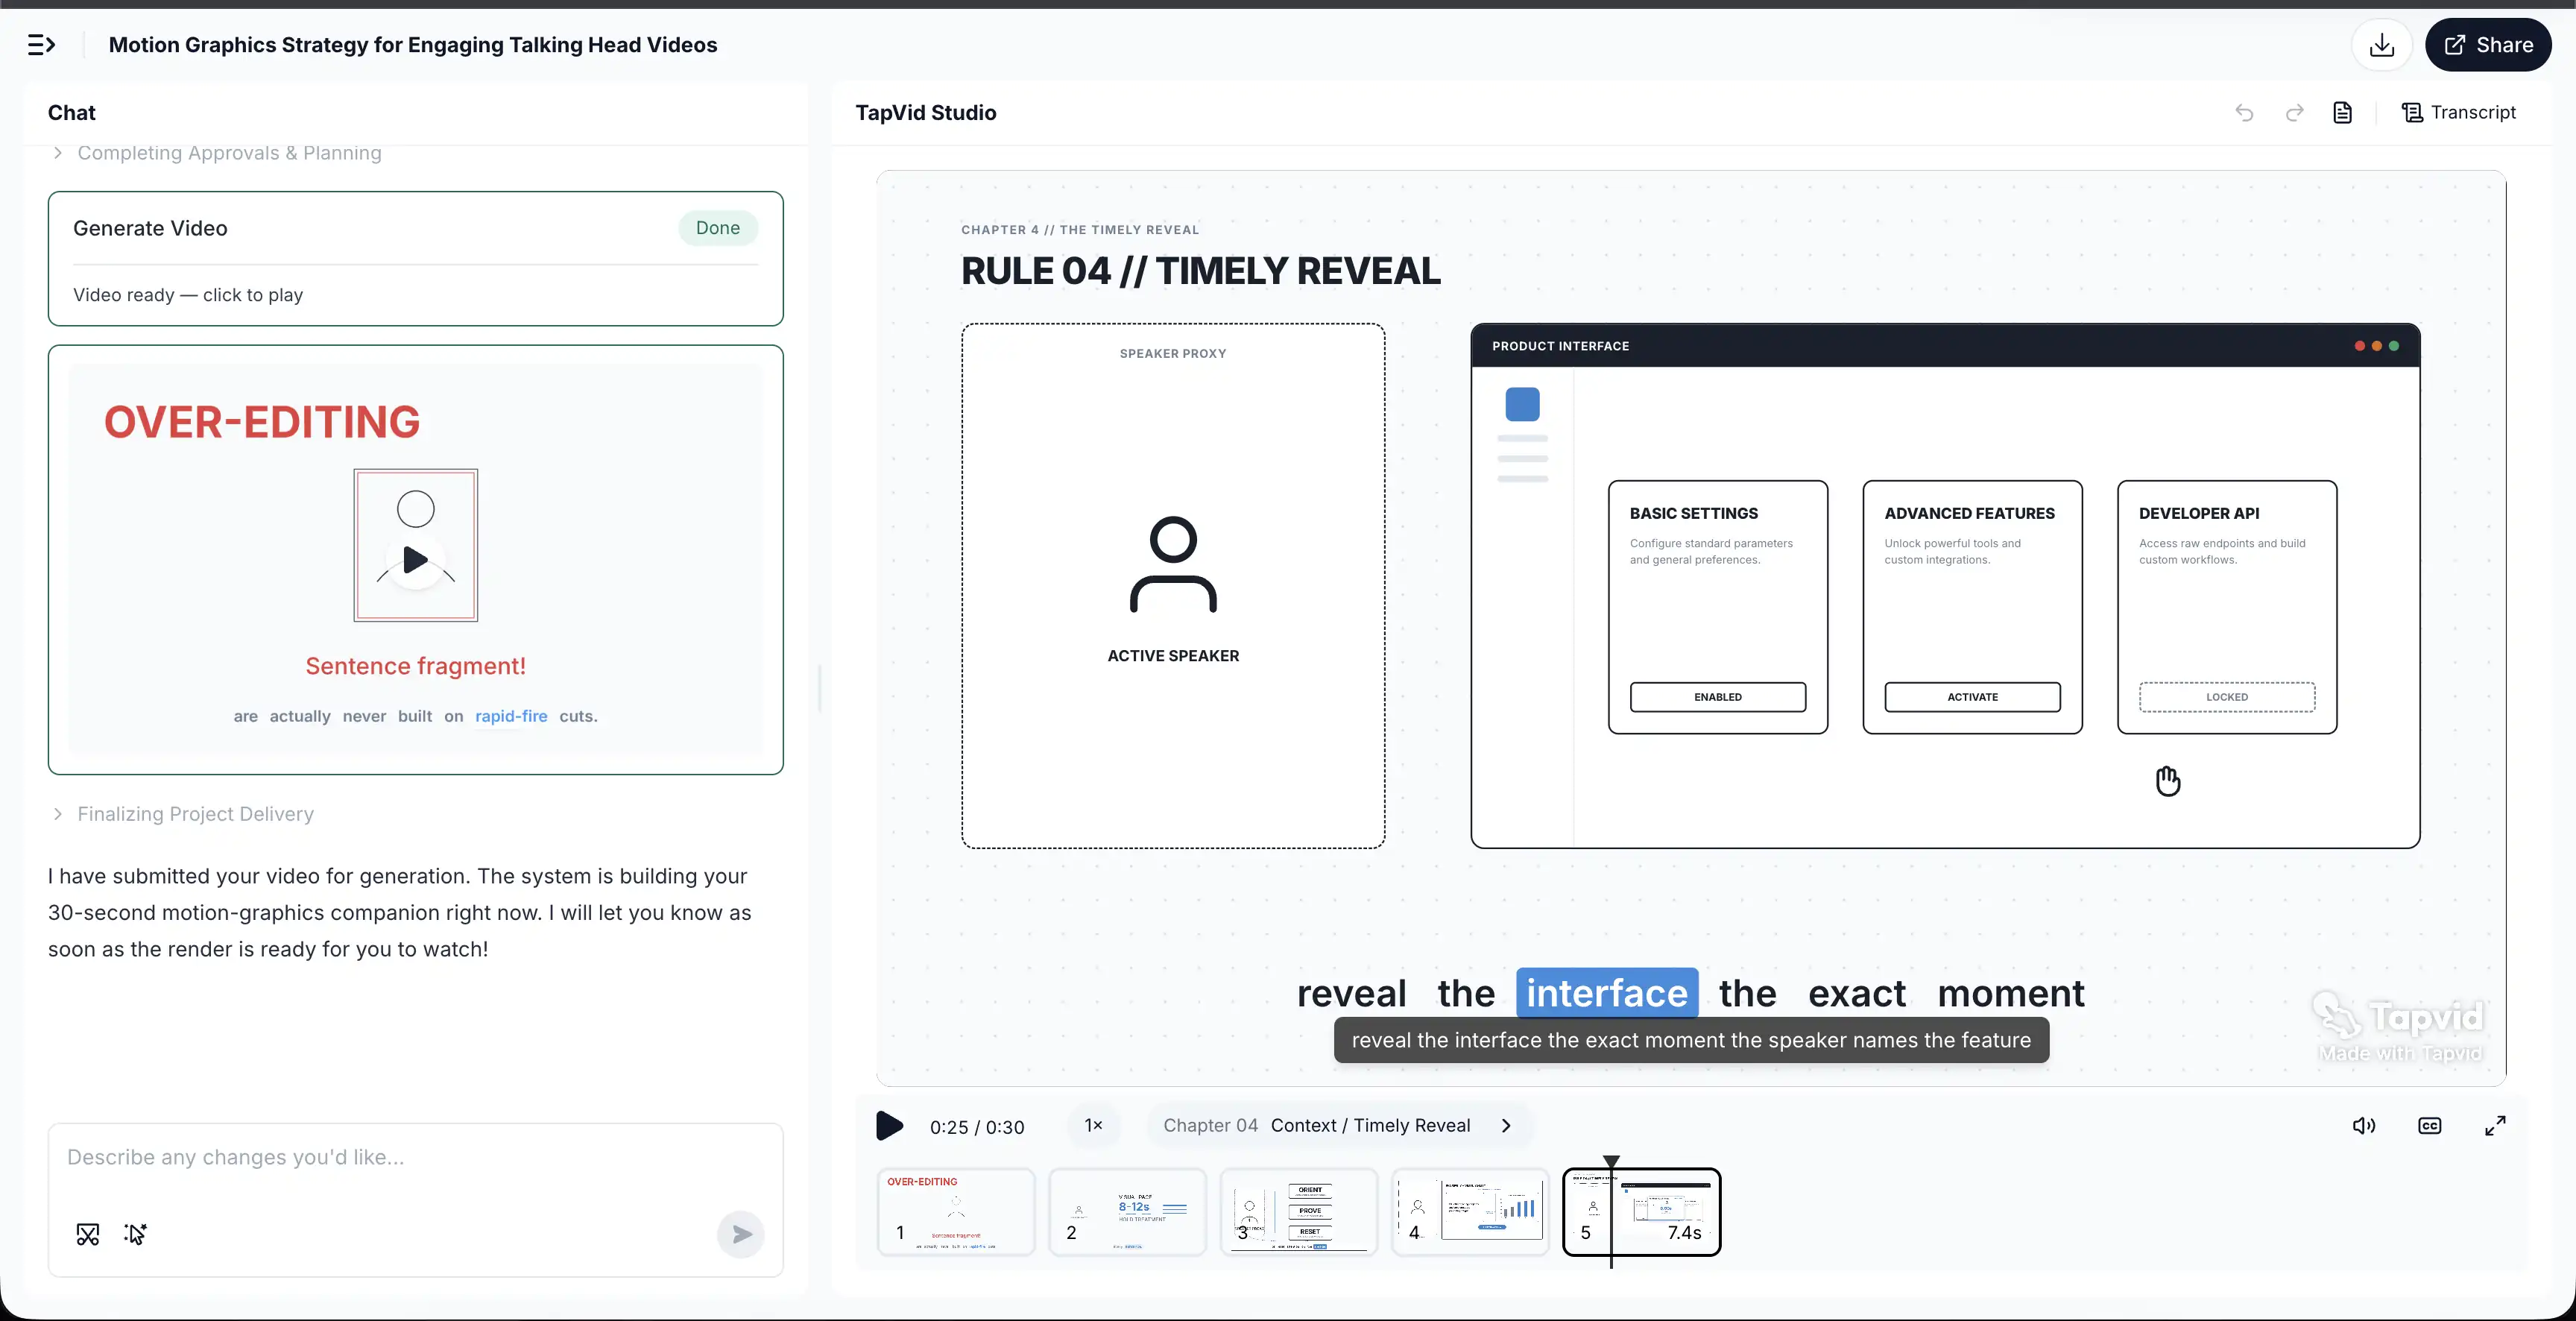
同一次執行的第二幀展示了 0:25 的及時揭示場景,並保留完整的 TapVid Studio 工作區。與只截取輸出畫面的局部圖不同,它保留了專案、Chat 狀態、播放器控制項、章節標籤和時間軸。這些脈絡能證明該畫面來自哪個產品與工作流程狀態,但不能驗證影片內部的主張。
把這條規則用於任何 AI 輔助 talking-head 剪輯:將每個數字、坐標軸、引用、介面狀態,以及"最佳"、"最優"或"最低"等評價詞,與轉錄稿和已批准來源逐一比較。即使構圖有用,也要刪除沒有依據的新增內容。本次運行中,高層視覺任務成立,但生成的量化層不成立。
證據邊界很窄。這次 prompt-to-video 運行說明,生成視覺可以保留所要求的關係,同時加入沒有依據的具體資訊。它不能證明觀眾留存、認知負荷下降、來源影片保真度,或應用於真實 talking-head 片段後的成片品質。
10
Talking Head 影片常見問題
Talking head 影片應該多長?
沒有統一理想時長。讓時長服務於一個清楚的觀眾任務,然後刪除重復和沒有依據的繞行內容。比較主題、受眾和分發語境相近的影片留存,不要從另一種形式生搬一個通用數字。
Talking head 影片應該多久加入一次 B-roll?
當旁白提到觀眾值得看到的具體物件、動作、介面、地點或事件時加入 B-roll,不要按固定計時器添加。個人故事可能長時間停留在說話者身上,而產品演示可能需要更頻繁的螢幕語境。
Talking head 影片需要字幕嗎?
包含必要音頻的預錄影片需要準確字幕來滿足無障礙要求。字幕應包含語音和相關非語音音頻,保持同步並經過錯誤檢查。關鍵詞動畫和裝飾性字幕不能取代完整字幕軌。
Talking head 影片適合什麼背景?
使用能讓說話者保持清晰、支持語境且不爭奪注意力的背景。檢查主體分離、雜亂、私密資訊和品牌相關性。純色背景不一定優於情境背景,但每個可見物件都應當是有意的或無害的。
應該用 AI avatar 替換真人說話者嗎?
當原始表演、身份或親身經歷是資訊核心時,不應該。Avatar 適合可重復的腳本交付和本地化,但它解決的是不同製作問題。如果真人錄制已經很強,就在其周圍加入解釋視覺。
AI 能在不改變表演的情況下讓 talking head 影片更吸引人嗎?
可以,前提是工作流把現有錄制當作來源,而不是生成替代主播。TapVid 是 Explainer Video Engine,其 talking-head 工作流旨在保留原影片和音頻,同時在周圍加入同步視覺層。請逐個語義單元核驗結果:標注是否正確、圖解是否匹配旁白、B-roll 是否相關、字幕是否準確,以及工具是否改變了聲明範圍之外的內容。
11
把現有 Talking Head 影片變成視覺 Explainer
最好的 talking head 影片不會為了運動而運動。它讓說話者繼續充當信任錨點,並在旁白引入數量、結構、關係或具體指代時,讓解釋變得可見。
從轉錄稿開始。標記會產生真實觀眾問題的語義單元,分配最小有用視覺,審核同步和可讀性,然後刪除不能改善理解的內容。這會形成一套可重復用於教程、創始人影片、產品講解、課程和社交短片的剪輯系統。
如果你已經有錄制和已批准的資訊,可以把它們帶入 TapVid 的 Explainer Video Engine,圍繞原始表演構建同步視覺層。