
过去六周,我一直把Veo 3放进真实的客户项目里跑——不是跑基准测试,也不是孤立的提示词,而是有真实截稿期的真实交付物。结果以我没料到的方式让我意外,而一些我以为会是致命短板的限制,最后其实根本无关紧要。以下是我的发现。
01
Veo 3究竟是什么,又不是什么
Veo 3是Google DeepMind的第三代视频生成模型。它能根据文本或图像提示生成最长两分钟的片段,时间一致性明显优于前代。而这最后一点,比任何其他规格数字都更重要。正是时间一致性,让AI视频看起来像视频,而不是一堆几乎相关的图像拼成的幻灯片。
Veo 3不是什么,则是它不是动态设计师的替代品。它不理解品牌体系,没有构图层级的概念,也不会知道你客户的红和模型的红是两种不同的颜色。每一份输出都需要人工审阅,多数情况下还要经过合成处理,才能拿给客户。
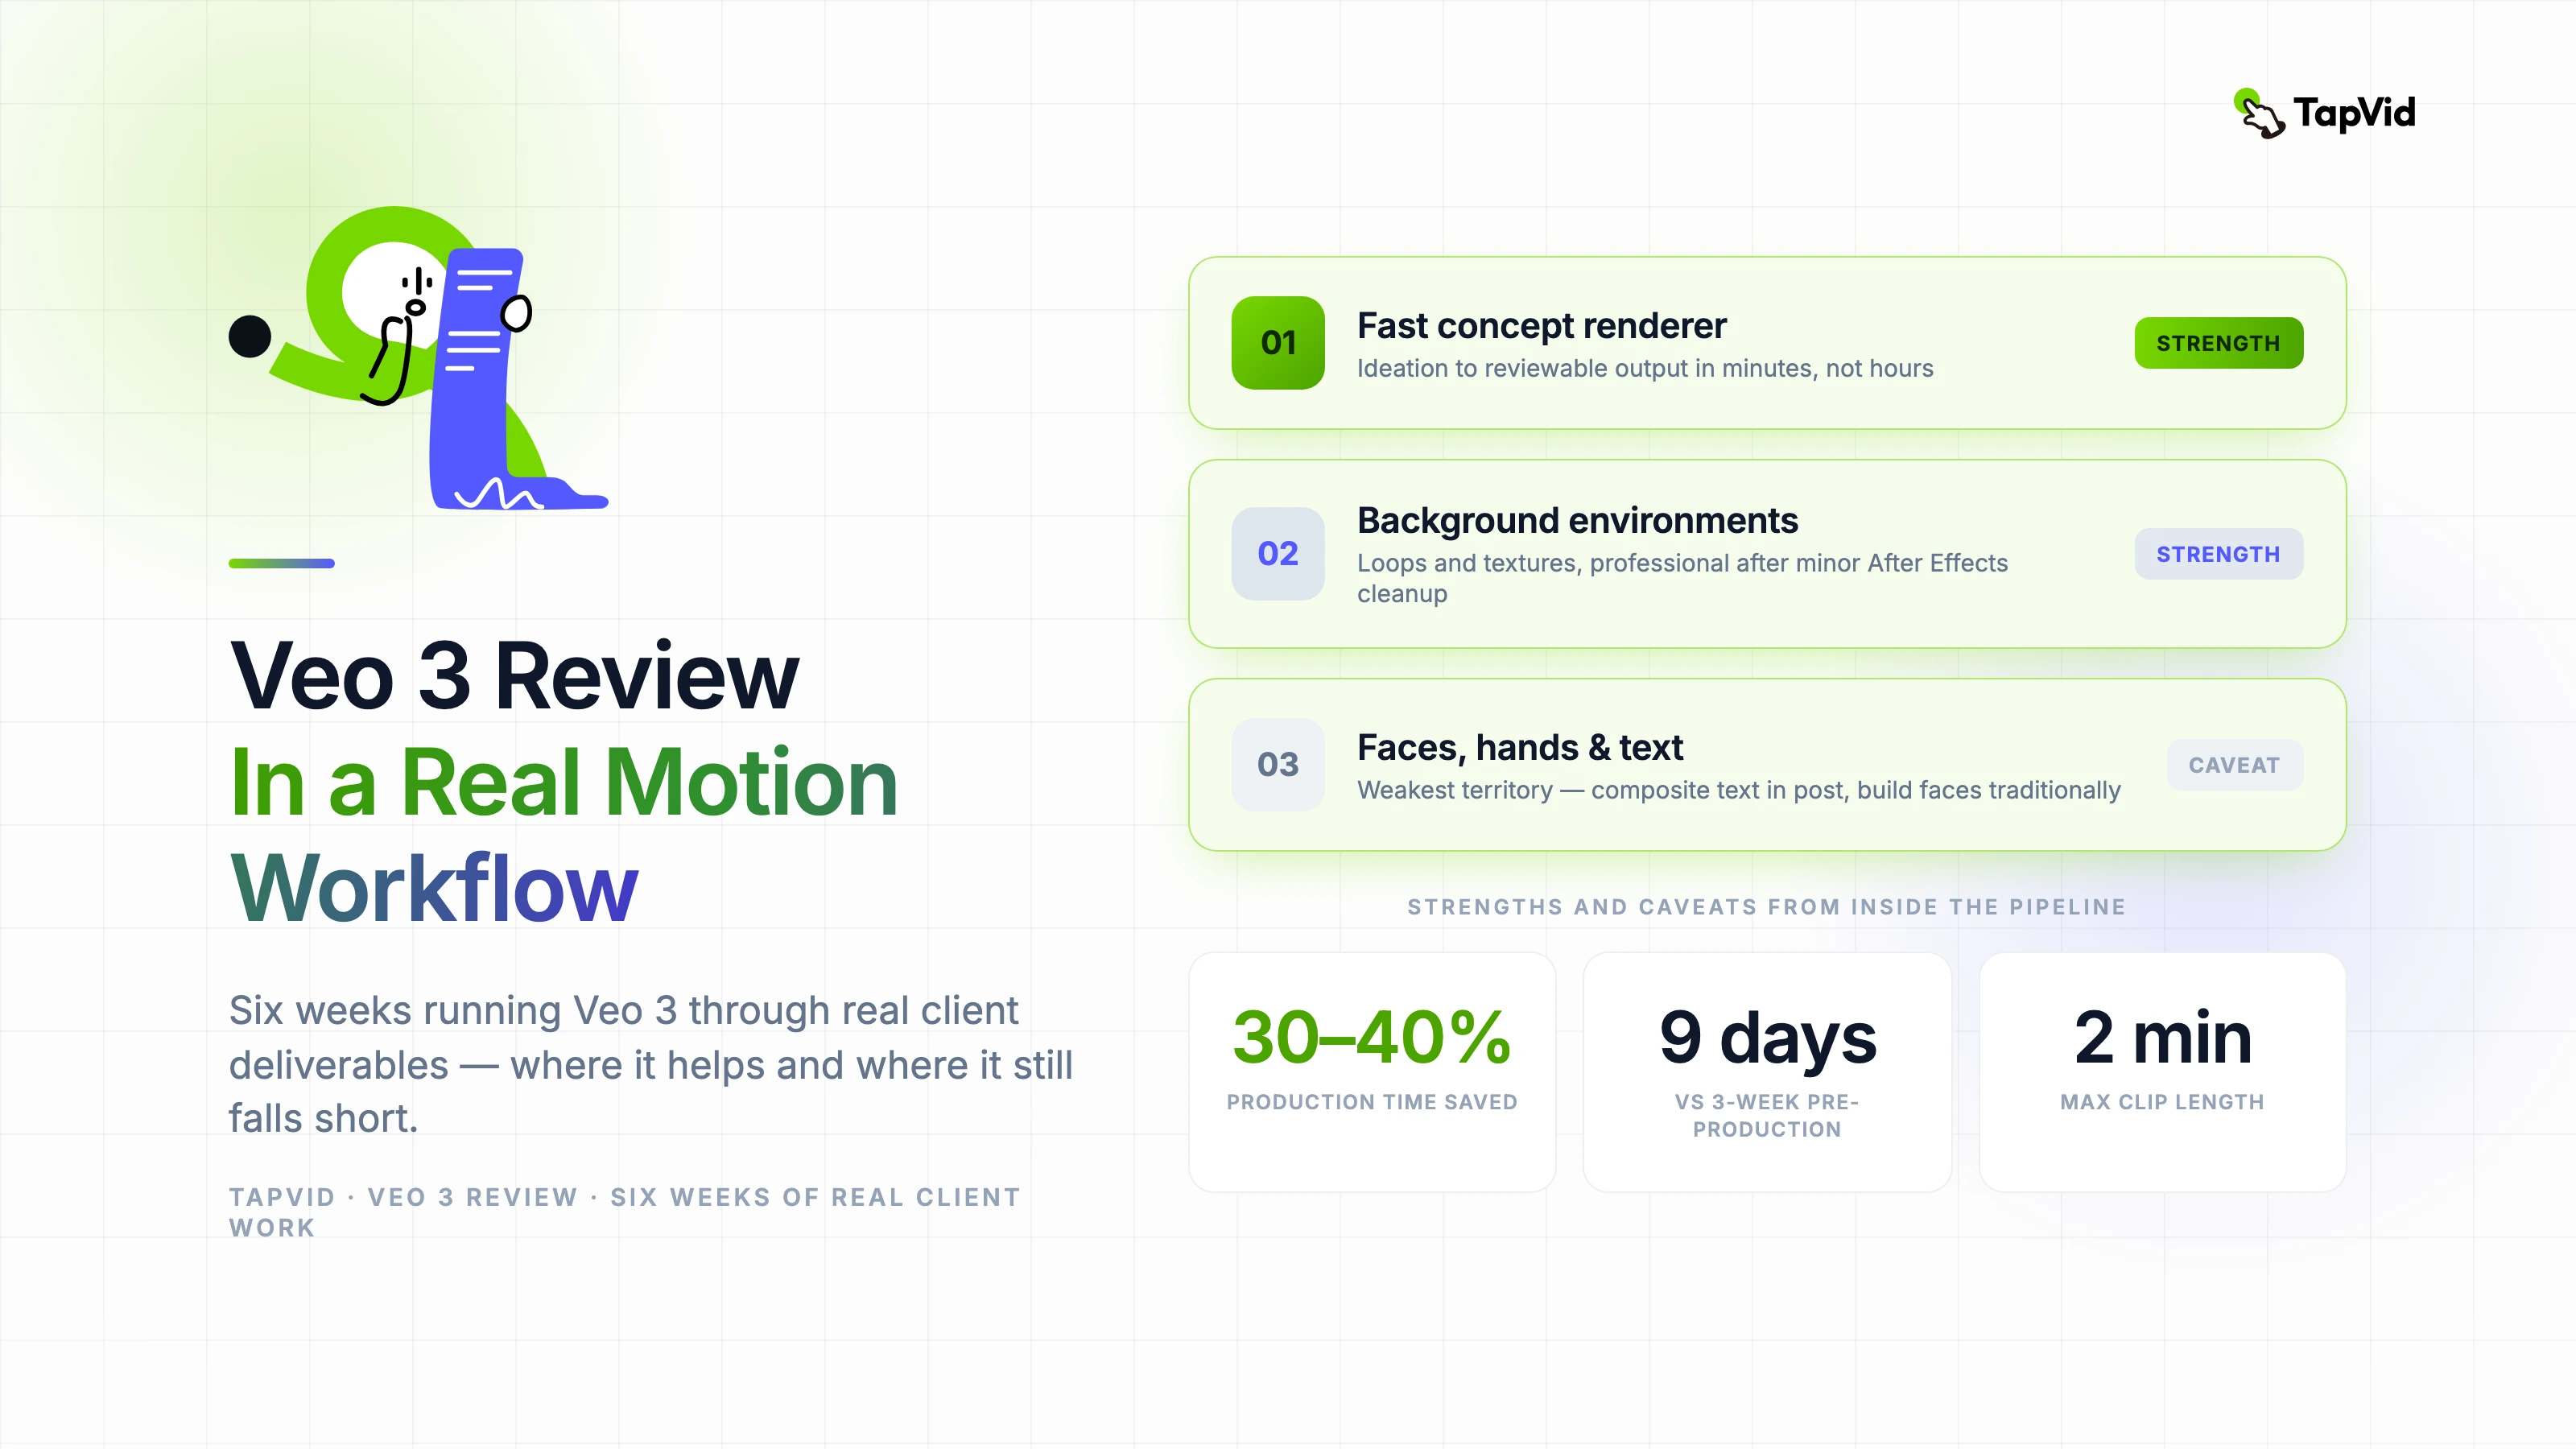
我最终确定的定位是:Veo 3是一个快速的概念渲染器。它把想法从口头变成画面的速度,比我用过的任何工具都快。从构思到可供审阅的成品之间的距离,过去要以小时计,如今则以分钟计。
02
Veo 3在真实的动态设计流程中该放在哪里
我最先测试的环节是概念构思。当客户简报进来、我需要在投入完整制作前给出三个方向选项时,Veo 3能让我生成粗略的视觉参考,其传达力远胜于静态分镜。客户会对动起来的东西有反应,他们凭直觉理解动态的方式,是再好的静帧也传达不出来的。
真正让我意外的第二个用途是背景生成。产品视频常常需要环境背景——办公空间、抽象的数据可视化、带纹理的循环画面——这些通常要靠授权素材或定制动画的时间才能拿到。Veo 3生成的背景循环,只需在After Effects里做点小清理,就完全显得专业。
我不会用它来做的是:主体动画、角色制作,以及任何需要与音乐轨道精确对齐时间点的东西。这个模型没有音乐节拍的概念,它的时间把控是概率性的。对于要和声音同步的工作,你仍得手工搭建。
03
真正适用于动态设计的提示词结构
在六个项目里写了大约200条提示词之后,我找到了一种能稳定产出可用结果的结构。先写镜头行为,再写主体,接着是环境,最后是视觉风格。「缓慢推近一个发光的全息界面,悬浮在昏暗的服务器机房中,柔和的蓝色环境光,电影感的景深」远比「服务器机房里的AI全息影像」产出更可用的结果。
负向提示在Veo 3中比在早期模型里更重要。明确说出你不想要的东西——「无文字叠加、无镜头光晕、无跳切」——会实质性地塑造输出。相比Veo 2,这个模型似乎能更可靠地对负向约束加权。
- 从镜头运动写起:推近、拉远、环绕、静止
- 精确描述主体行为——「缓慢旋转」胜过「移动」
- 指定光照类型:环境光、方向光、轮廓光、霓虹辉光
- 加上风格参考:「电影感」「平面图形」「动态图形风格」
- 对模型默认爱加的东西用负向提示:无镜头光晕、无文字
04
我在客户项目中真正撞上的限制
手和脸仍是这个模型最薄弱的领域。对于任何需要辨认得出人脸的镜头——代言人视频、证言式内容、带人机交互的产品演示——可供客户使用的帧的产出率低到我用传统方式做这些镜头反而更快。
文字渲染依旧不可靠。如果你的画面里有需要辨读的文字,别指望Veo 3把它生成对。文字要放到后期去合成。每一次都是。
另一个真实的限制是输出分辨率。在当前的画质档位下,用于广播或大幅面几乎总要做放大处理。这是流程里必须计入预算的额外一步。它算不上致命短板——放大工具又快又好——但也不是零成本。
05
它如何改变了我真实的制作排期
在最近一支SaaS产品发布视频里,我用Veo 3做背景环境、抽象的数据可视化循环,以及概念方向。本来要三周的前期制作过程,只花了九天。客户获得了更多轮方向评审,因为我能在几分钟而不是几小时内生成备选方案。
诚实的数字:我估计Veo 3节省了该项目总生产时间的30-40%,几乎完全集中在构思和环境资产阶段。在背景工作较少、角色动画更多的项目上,这个数字会大幅下降。在决定Veo 3可以携带多少重量之前,先了解您正在从事什么类型的项目。