
TL;DR
从一份自有素材、一个受众结果和每句话的画面任务开始。本次 30 秒 TapVid 实测生成 5 个场景,之后只重生成第 5 个场景,第 1 到第 4 个场景保持不变。
无真人出镜视频不让创作者担任镜头前的主持人,而由旁白、动态图形、录屏、文档、图表、手部演示或精选 B-roll 承担解释。但研究、版权核验、事实审核与最终发布责任仍然属于人。
01
无真人出镜视频是什么,不是什么
无脸视频是指创作者不充当屏幕主持人的视频。故事可以通过旁白、动态图形、屏幕捕获、文档、图表、手部镜头、许可的档案材料或精心挑选的B-roll进行。公众人物仍然可以出现在新闻图片中,客户仍然可以出现在许可的镜头中。定义点是,创造者不是视觉锚。这是一个制作选择,而不是承诺视频是匿名的、无声的、全自动的或不受人类判断的。
无脸和画外音不是同义词。《无脸》描述了屏幕上出现的人,而旁白描述了旁白是如何录制的。无声的定格动作教程可以不露面,而从创作者的角度来看,带有采访的纪录片仍然可以不露面。这种格式可以帮助专业创作者或小企业在没有工作室日的情况下发布,但它创造了更严格的视觉义务。如果没有脸作为稳定的焦点,每个图表、界面动作、标签和剪辑都必须帮助观众遵循论点。
02
五种类型分别解决什么问题
动态图形讲解视频适用于系统、比较、数字和因果关系的说法。屏幕录制的教程适合软件和操作工作流程,因为界面成为证明。B-roll和旁白适合地点、身体动作和气氛,但通用镜头不应该作为证据。手工演示适用于工艺、烹饪、维修和实物产品。当确切的术语、地图、图表或文档摘录比演示者更重要时,文本主导或插图故事就有效。
通过询问观众必须看到什么才能相信或理解这一说法来选择格式。如果声明存在设置,请显示界面。如果声明是一个选项在定义的指标上优于另一个选项,请显示比较和来源。如果索赔涉及物理过程,请展示手和物体。一个常见的弱势模式是将松散相关的素材库片段放在每个句子下。它创造了运动,但观众学到的更少,因为图片没有进行清晰的解释工作。
| 类型 | 创作者出镜? | 由什么承担叙事 | 适合场景 |
|---|---|---|---|
| 动态图形解说 | 否 | 旁白、图表、文字 | 系统、数据、教育 |
| 录屏教程 | 通常否 | 界面与讲解 | 软件、培训、支持 |
| B-roll 加旁白 | 否 | 实拍、档案、旁白 | 地点、动作、纪实 |
| 手部演示 | 不露脸 | 手、对象、标签 | 工艺、产品、维修 |
| 文字或插画 | 否 | 文字、地图、文档 | 精确术语和抽象主题 |
03
从自有素材到第一版成片的实测流程
可靠的工作流程在想法和研究获得批准后开始。说出一个受众和一个结果,然后带来你控制的来源:文章、脚本、报告、演示文稿、采访笔记、产品简介或已批准的网页。将书面散文转换为口语,将证据附加到它支持的主张上,并建立一个两列计划,左边是叙述,右边是视觉动词。有用的视觉动词包括比较、定位、揭示、演示、注释和证明。像“仪表板”这样的名词还不是视觉指令。
2026年8月11日,我在TapVid中用一个名为StockPilot的虚构库存SaaS为五人零售运营团队测试了这个过程。制作需求要求使用Adam Deep的声音、字幕、背景音乐和产品发布风格制作一个30秒的16:9英文产品视频。它提供了一个事实机制,14天库存远见,并禁止编造的客户指标或推荐信。源头故意小到足以逐行检查。这很重要,因为不露面的工作流程应该保留已批准的事实,而不是在有吸引力的运动后面隐藏模糊的发明。
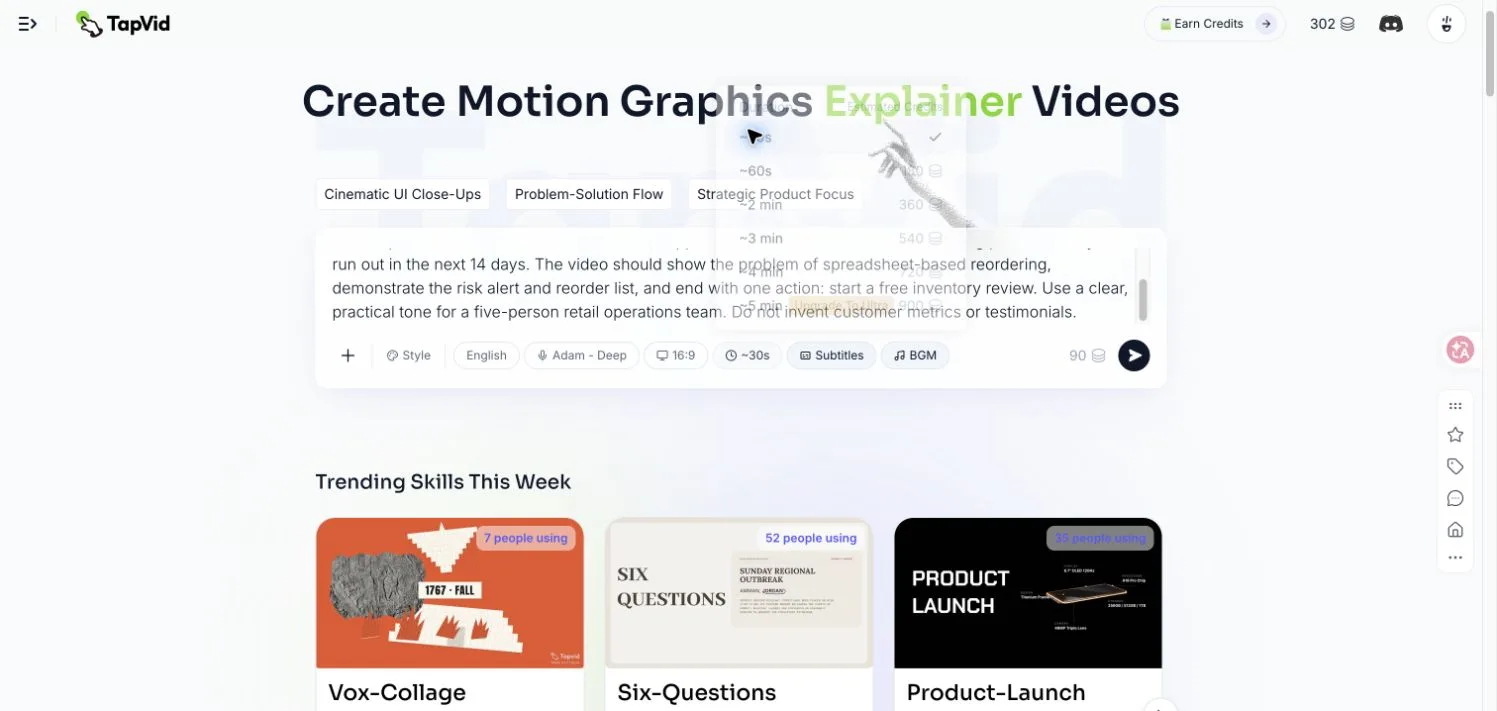
TapVid 把 brief 变成概念、脚本和 5 个可编辑场景:表格混乱、品牌揭示、仪表盘演示、14 天缺货风险预测和 CTA。第一次在渲染前失败,Retry 继续同一个项目。最终成片 30 秒,观察到消耗 90 credits,余额从 302 变成 212。这是一次实测,不是普遍承诺。
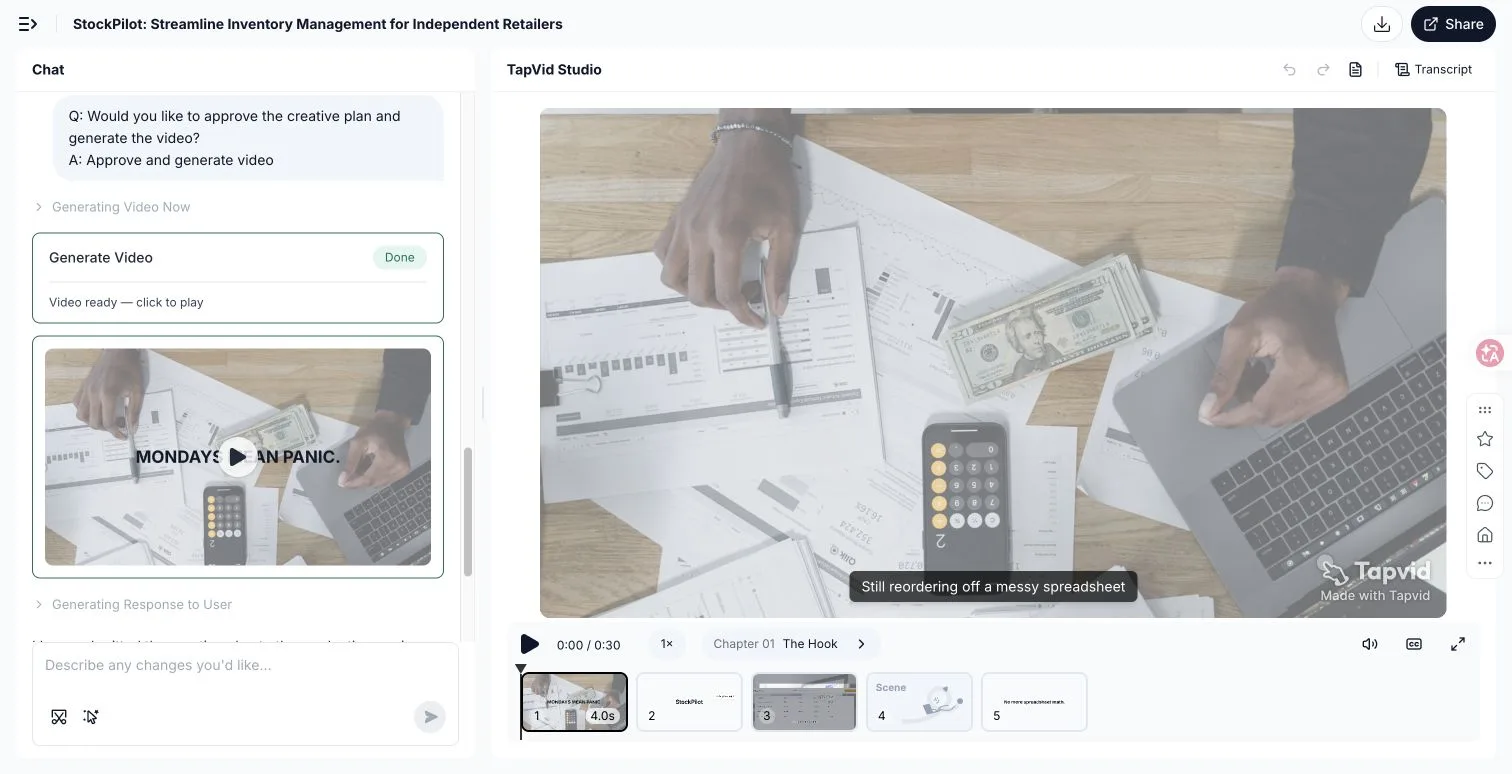
下面的嵌入式公共TapVid示例是一个单独的45秒无脸产品视频,关于选择儿童水瓶。我在2026年8月12日查看了公众球员和成绩单。它使用产品图像、确切的材料标签、秋季测试声明、功能比较、旁白和标题,没有镜头前演示者。它被嵌入为真正的可玩结果,但它没有标记为StockPilot输出。StockPilot证据显示在上面的已登录屏幕截图中,因此两个来源仍然不同且可追溯。
04
只改一个场景,不重新生成整条视频
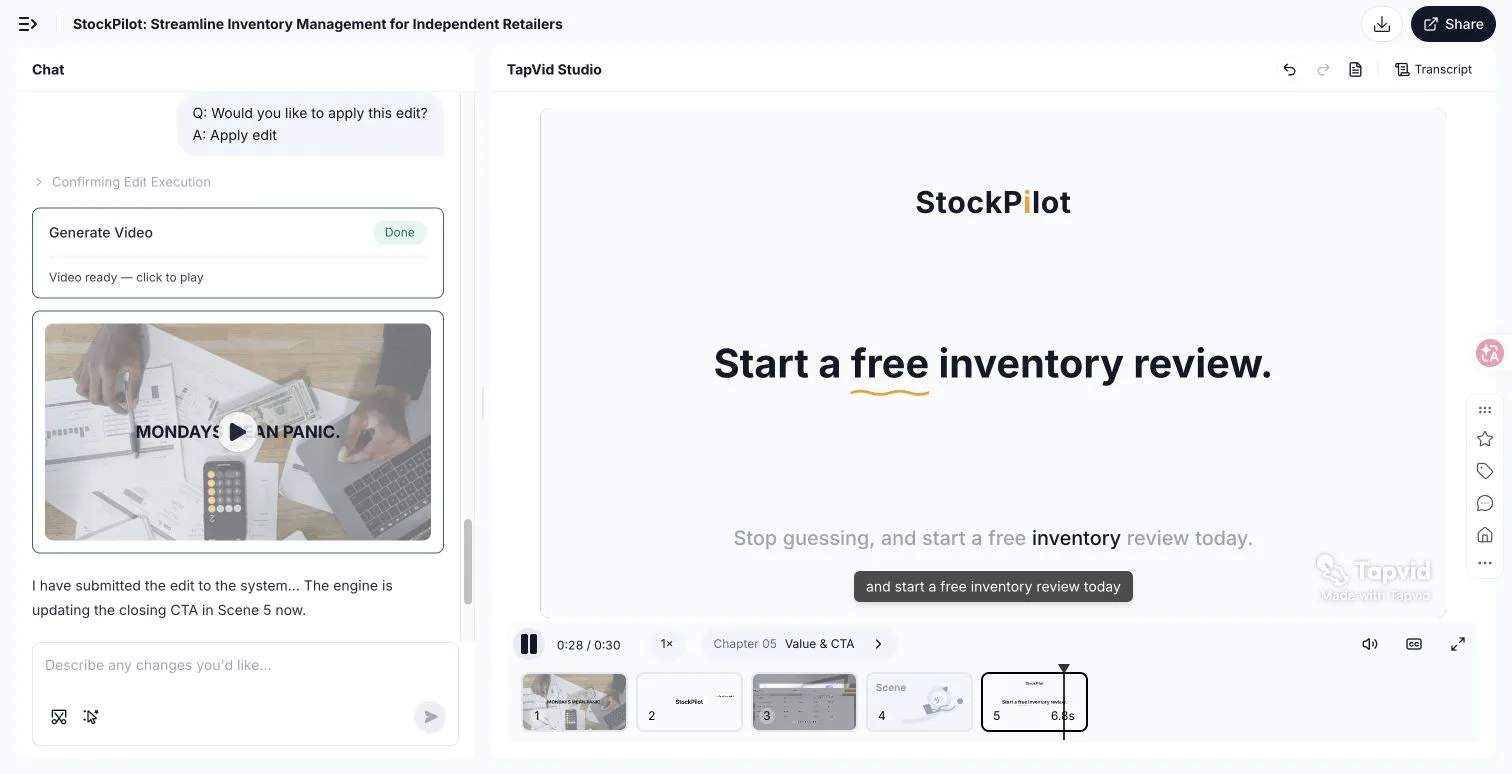
最大的生产优势不仅仅是产生第一次切割。它正在纠正一个薄弱的场景,而不丢弃已批准的工作。在StockPilot项目中,我选择了场景5,并使用基于提示的场景编辑,只更改了屏幕上的关闭行动号召,同时保留了视觉效果和时间。这就是场景级编辑的实际含义:确定目标,陈述确切更改,保留其余部分,并根据批准的来源审查新版本。它将本地修正变成本地任务,而不是全视频重建。
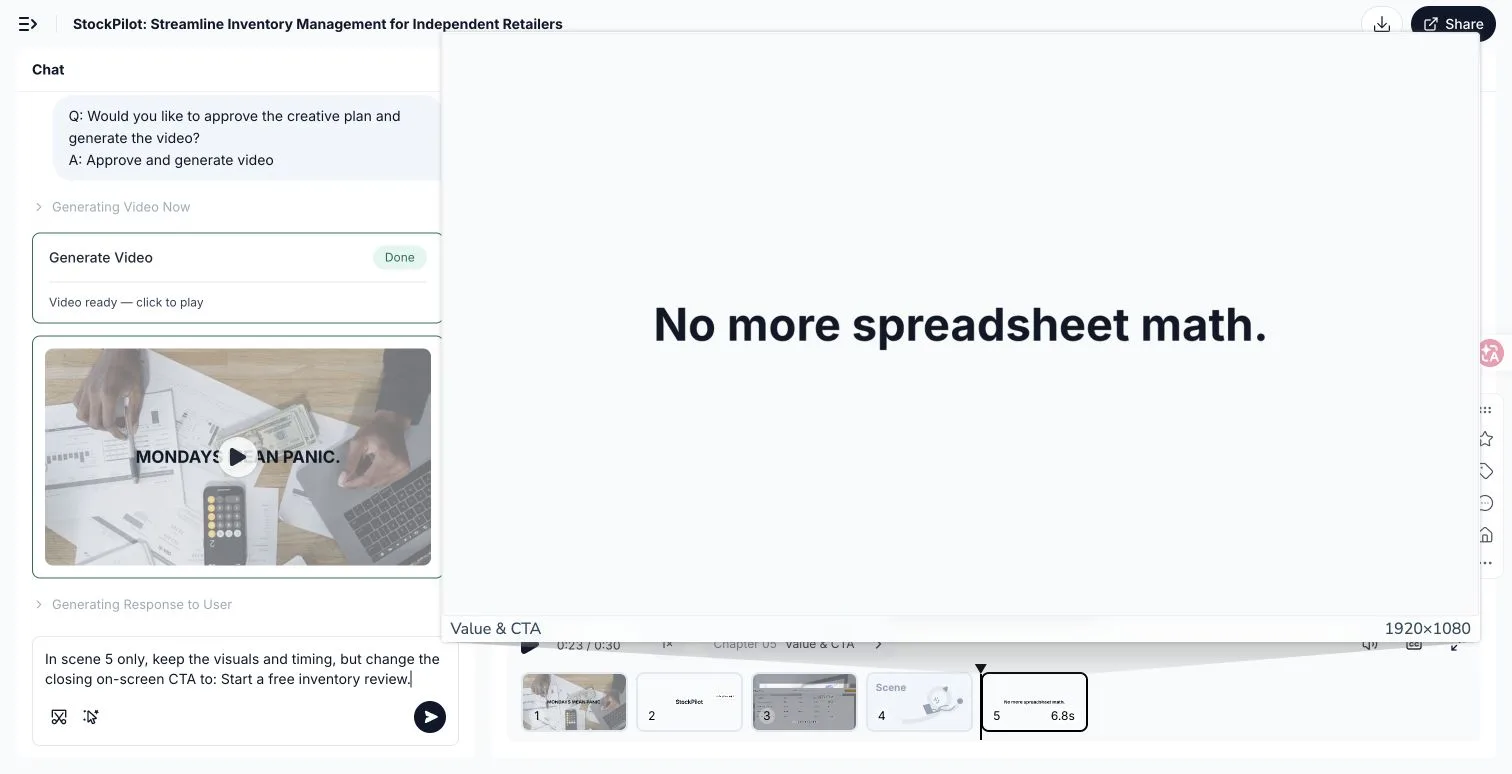
TapVid 识别出目标 `c5-s1`,展示修改方案,创建新版本,并在 0:28 渲染出“Start a free inventory review”。总时长仍是 30 秒,第 1 到第 4 个场景保持不变。这对需要批量交付的机构和中小企业很关键,但修改后的场景仍需审核事实、画面和版权。
05
完整查看过的三个公开案例
2026年8月12日,我还打开并审查了三个TapVid无脸讲解视频的完整公共共享播放器和成绩单。政策视频运行4:20,人口统计视频5:08,预测市场视频5:19。没有使用演示者作为视觉锚点。这些不是从缩略图中猜测的十秒。观察来自可访问的播放器、开场视觉效果、章节标签和完整的可见成绩单。这些案例显示了三个可重复的视觉系统:文档和注释图表、地图和数据线,以及与精确信息图形相结合的存档图像。
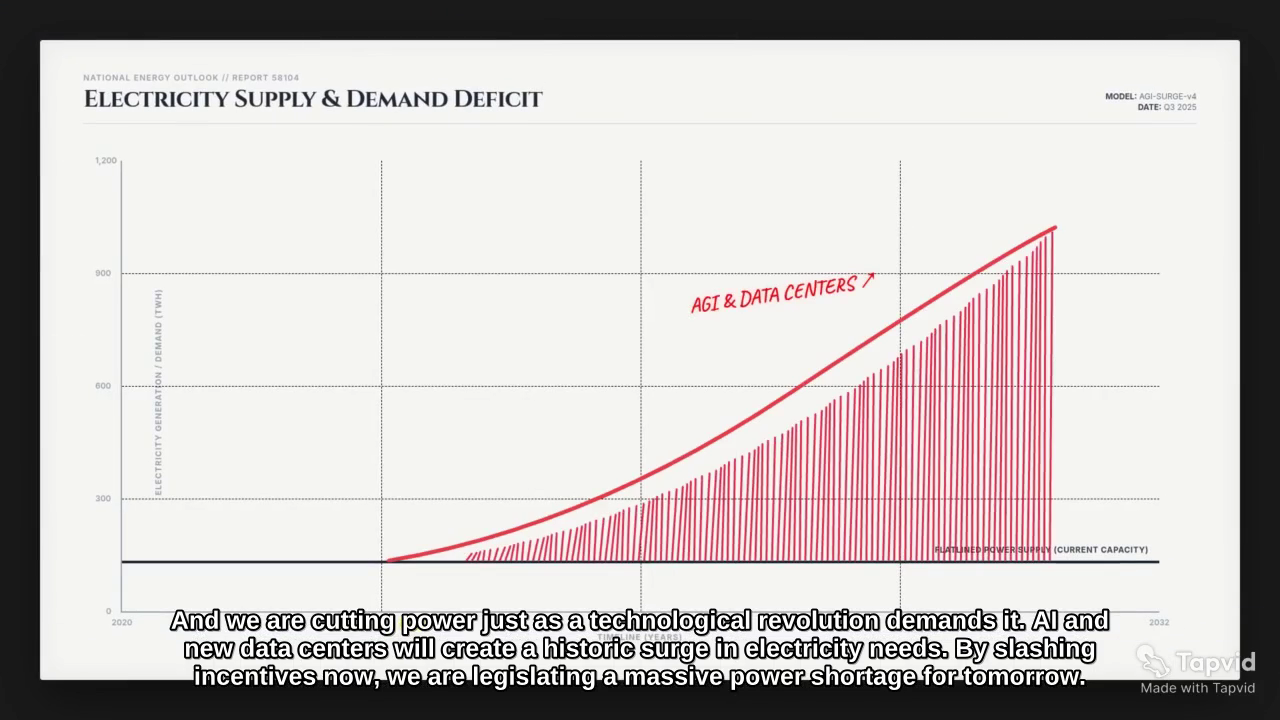
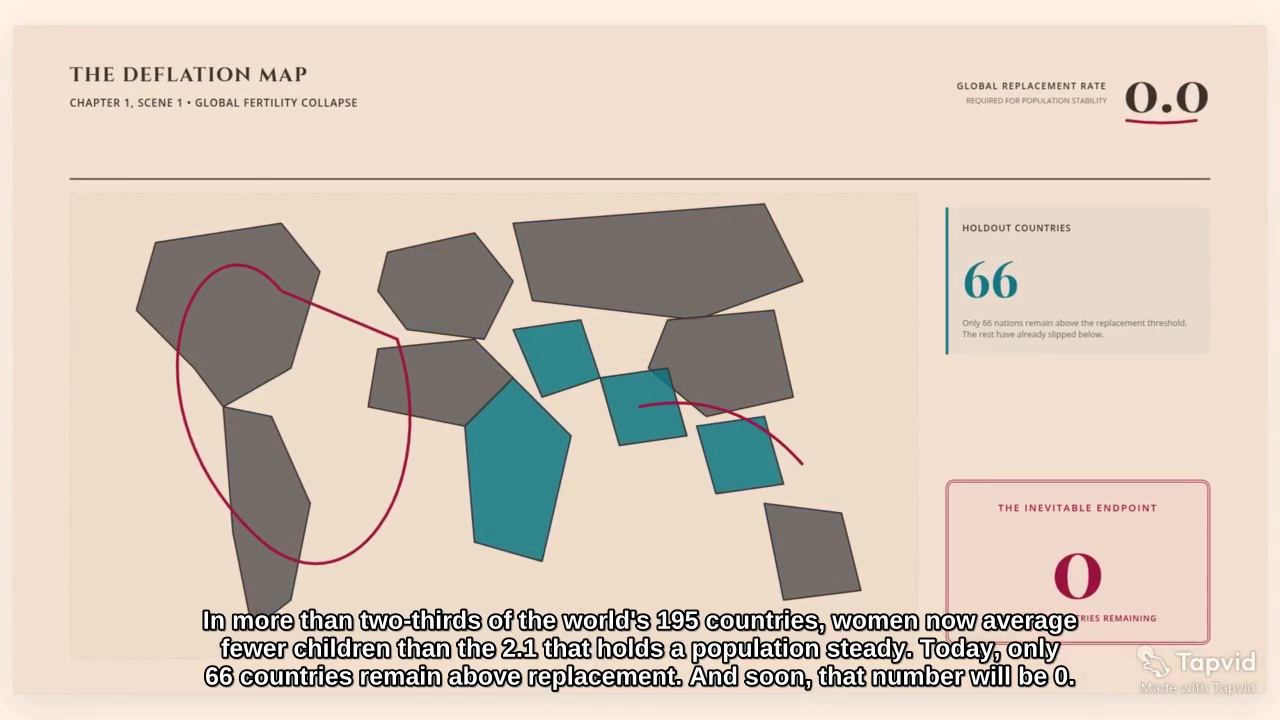
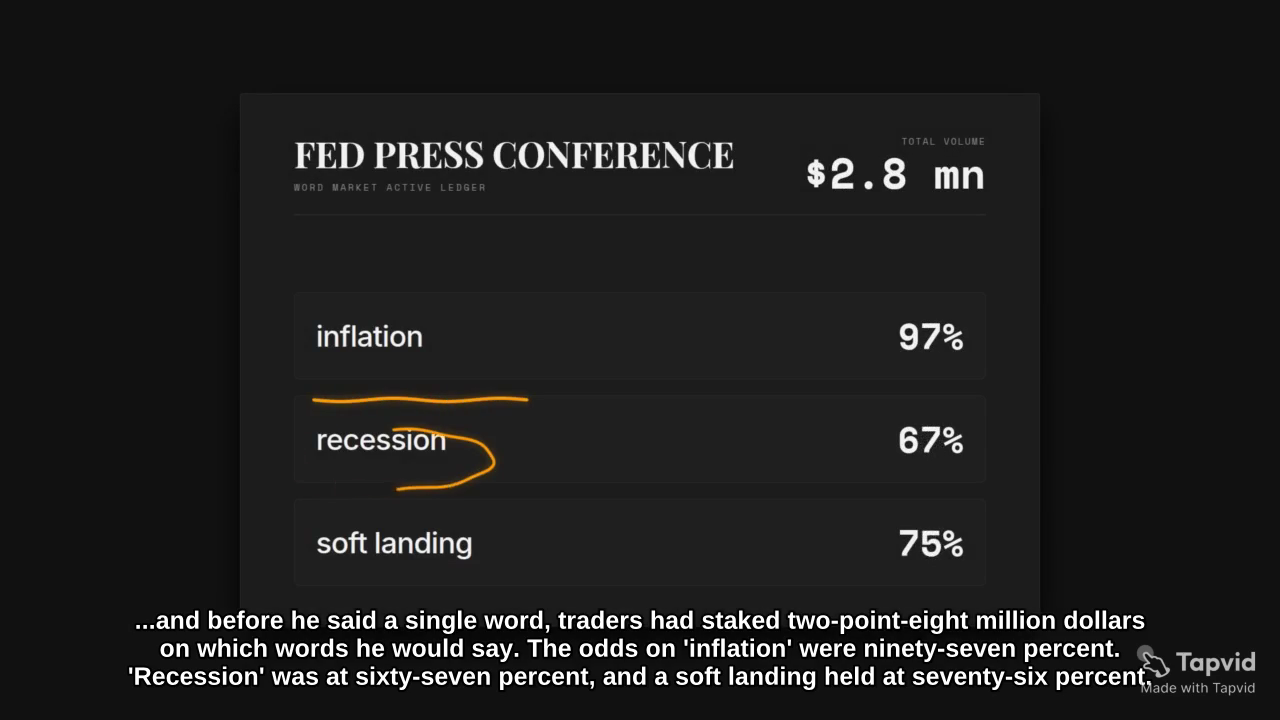
政策讲解视频作为一个编辑台打开,上面有一份日期的报纸、照片、图表、表格和红色注释。出生率讲解视频以全球更替率地图开场,并经历了倒金字塔论点、跨国比较和智能手机时代的时间表。预测市场讲解视频结合了新闻发布会设置、概率合同、平台价值、历史参考、争议机制和突出显示的赔率。在每种情况下,声音决定证据何时进入,而视觉系统则告诉观众看哪里。
这些例子并不能证明每个无脸视频都需要密集的动画。他们证明了视频需要一致的语法。文件应该看起来像同一张桌子的一部分。相同的颜色应该意味着相同的类别。一张图表应该足够长,以便口头比较陆地。大气录像可以确定位置,但确切的声明属于可读的图形。目标不是不断的运动。这是受控的注意力,每个场景执行一项工作,序列解决了开头承诺的问题。
06
如何让无真人出镜视频保持吸引力
以一个真正的问题或后果来引导,而不是“今天我们将谈论”。更改信息,而不仅仅是更改背景。通过例子、选择和判断来赋予叙述一个观点。重复布局、颜色和章节模式,以便观众学习如何阅读视频。让重要的框架呼吸,特别是在移动设备上。最后,用三种方式测试草稿:在没有声音的情况下观看以评估视觉逻辑,在没有图片的情况下听以评估旁白,以及一起观看以找到文本、声音和动作竞争的地方。
- 从一个问题、张力或具体后果开场。
- 每个场景只承担一个画面任务和一个证明任务。
- 旁白说到数字和名称时同步展示。
- 重复使用颜色、标签和章节样式。
- 发布前核对事实、版权、字幕、手机可读性和 CTA。
07
原创性、版权、AI 披露与变现
无脸内容可以是原创的和可货币化的,但相机格式不会创造原创性。从您拥有或获得许可使用的材料开始,添加报告、分析、示例或说明,并保留镜头、图像、音乐、声音和声明的记录。YouTube根据其当前的货币化政策评估重复性和大规模生产的材料,并要求披露可能误导观众的现实合成或更改描述。在释出之前重新检查平台规则,特别是对于金融、健康、政治、公众人物或正在展开的事件。自动化应该组织和可视化您的工作,而不是伪装借用或未经验证的工作。
08
根据素材选择视频类型
从最强的来源中选择。一篇完成的文章或研究笔记通常会成为旁白的讲解视频。软件任务变成了带有旁白的屏幕录制。数据报告变成了动画图表和注释文档。实物产品或工艺品成为只动手的演示。没有相机镜头的个人故事可以使用插图、许可的档案材料或限制性的B-roll。保持第一个版本狭窄:一个受众,一个承诺,一个来源,一个宽高比和一个下一步。然后使用场景级编辑来纠正本地问题,而无需重新打开已批准的部分。
| 最强素材 | 优先形式 | 原因 |
|---|---|---|
| 文章或研究 | 旁白解说 | 结构和证据已经存在 |
| 软件流程 | 录屏加讲解 | 界面能直接证明 |
| 数据报告 | 动态图表与文档 | 关系和准确标签最重要 |
| 实物或工艺 | 手部演示 | 动作本身就是证明 |
| 没有拍摄素材的个人故事 | 插画、档案或 B-roll | 旁白承担观点 |
09
常见问题
无真人出镜视频等于旁白视频吗?
不等于。前者描述创作者是否出现在画面里,后者描述一条单独录制的音轨。两者经常组合,但不是互相要求。
可以出现其他人的脸吗?
可以,只要与内容相关并拥有适当授权。无真人出镜通常指创作者不是主持人,版权、语境和合成媒体规则仍然适用。
一定要用 AI 配音吗?
不。您可以录制自己的旁白、聘请配音演员、使用采访或依靠文本和自然声音。确认使用权和当前披露要求。
YouTube 可以给这类视频变现吗?
是的,如果频道符合程序要求,并且内容是原创的、有用的、权利清除的和合规的。露脸不是货币化要求。
最容易制作的是哪种?
通常是最接近你现有素材的形式。作者可以从文章开始,软件团队从录屏开始,产品团队从批准后的 brief 开始。