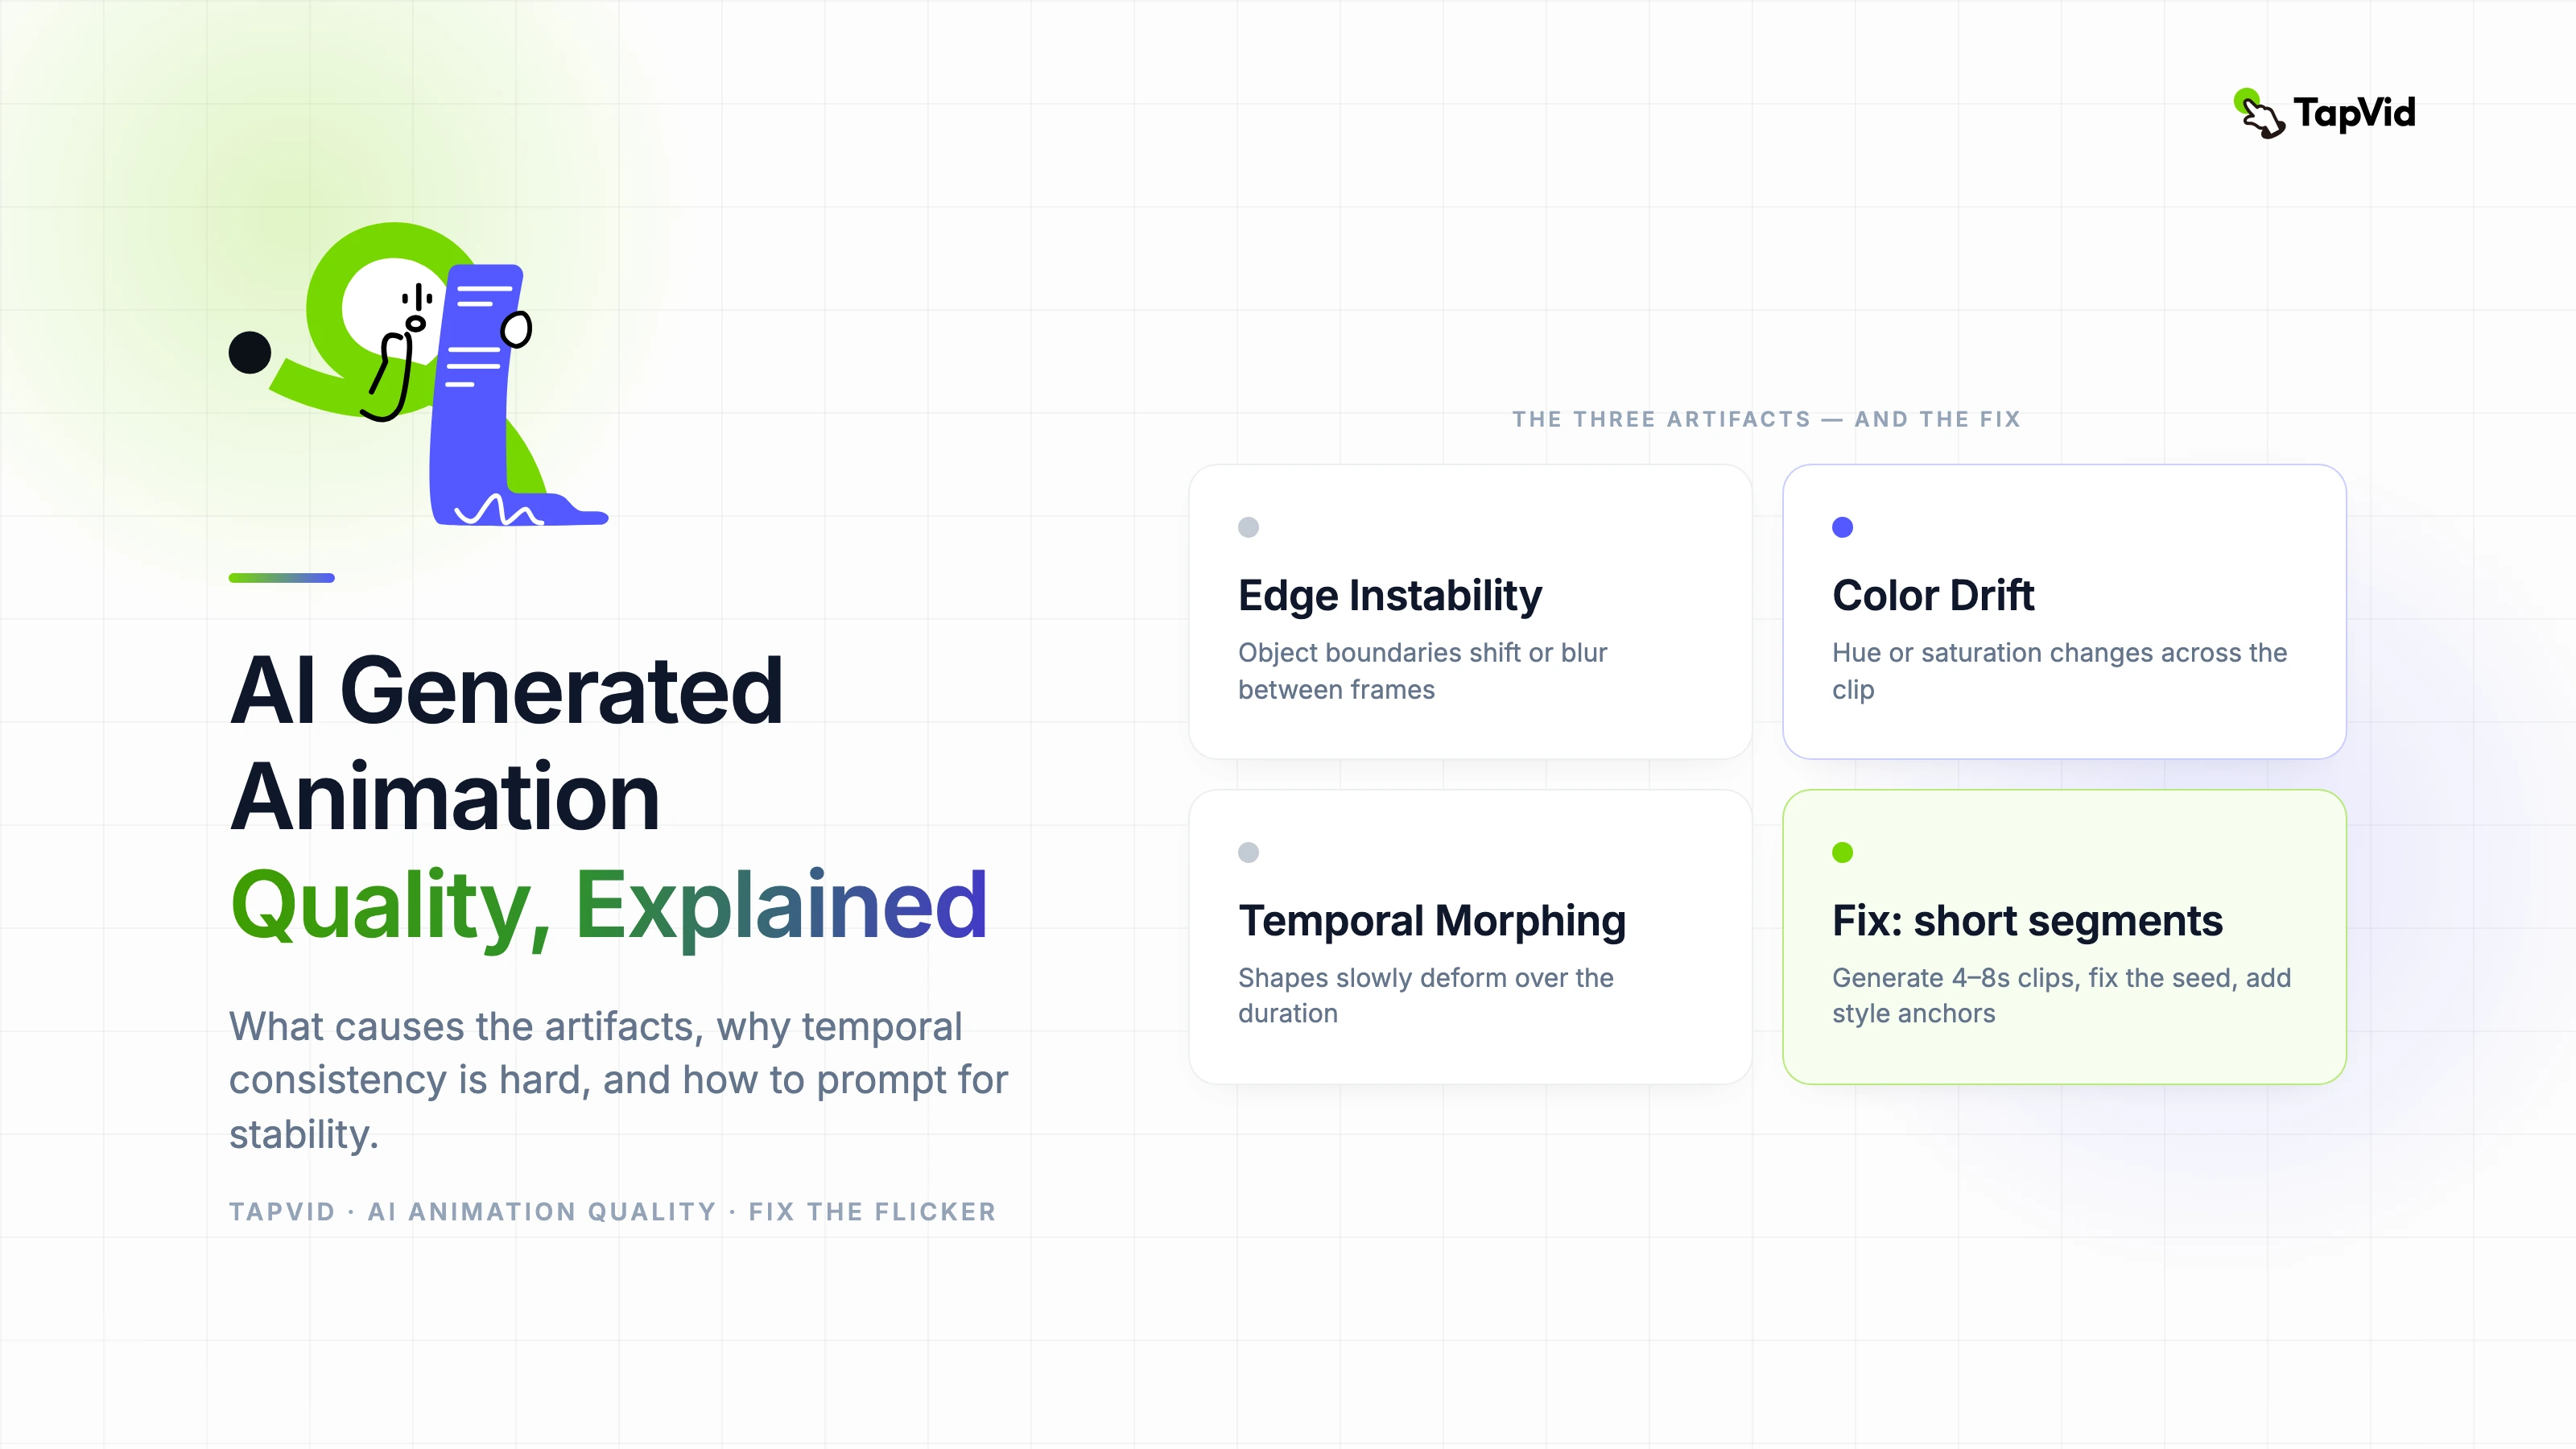

关于 AI 生成动画,最常见的抱怨是它“看起来很 AI”。人们这么说时,通常指的是某个具体环节技术上出了问题——脸在帧与帧之间轻微变形、logo 边缘闪烁、动作不遵循真实物理。一旦你弄清成因,这些都是可解决的问题。问题不在于模型不好,而在于“生成”和“一致性”是两个不同的技术难题,而大多数工具只部分解决了后者。
01
AI 视频生成究竟是怎样产生画面的
当前的视频生成模型大多基于扩散(diffusion):从噪声出发,逐步细化,最终得到与条件信号——你的提示词、参考图,或两者——相匹配的输出。这种细化发生在被称为“潜空间(latent space)”的视觉空间压缩表示中,而非直接作用于像素值,这也是生成在当前硬件水平下具备可行性的原因之一。
逐帧生成与时间(temporal)生成之间的区别,对输出质量影响极大。逐帧模型在带有少量共享上下文的情况下独立生成每一帧——速度快,但会产生闪烁,因为每一帧都是对同一提示词略有不同的解。时间模型则显式地在时间维度上建模运动,输出更平滑,但所需算力大得多。
面向消费者的大多数工具,会以某种方式组合使用时间注意力机制:既把相邻帧关联起来,又在较长序列中允许独立生成。理解这一架构就能明白,为什么短片段往往比长片段更一致——时间注意力的窗口是有上限的。
02
时间一致性:为什么在技术上很难
时间一致性,指物体、纹理和光照在帧与帧之间保持稳定,且符合物理世界的运作方式。当它失效时,人类极其容易察觉——我们一辈子都在观察物理现实——但要在生成模型中强制做到这一点,却是真正的难题。
核心问题在于:即便以前面的帧作为条件,扩散模型对每个解的生成仍相当独立。去噪路径上的细微差异,会在像素层面产生视觉上不同的结果,哪怕语义内容完全相同。这些差异在帧间不断累积,表现为闪烁。
模型通过多种机制来应对:强制相邻帧像素级一致的光流(optical flow)约束、沿时间维度传播特征的注意力机制,以及锚定物体应如何运动的显式运动条件。目前没有任何模型能在高分辨率下同时完美解决这三者。
03
让输出更一致的提示词工程
- 风格锚点:加入具体的视觉风格词(“赛璐璐动画”“干净矢量”“照片级写实”)——它们能约束生成空间、降低方差
- 负向提示:明确排除常见瑕疵类型(“闪烁”“变形(morphing)”“扭曲边缘”)——模型会对负向条件作出反应
- 种子控制:在对一个可用结果做迭代时固定生成种子——这能保留产生优质输出的初始化状态
- 参考图:用风格参考图进行条件约束,得到的色彩和纹理会比纯提示词生成一致得多
- 保持简短:以 4–8 秒的片段生成以获得最佳一致性——越长的生成积累的时间漂移越多
04
如何系统地评估 AI 动画输出
先以 1× 速度逐帧检视一遍输出,再以 25% 速度看一遍。留意三种最常见的瑕疵:边缘不稳定(物体边界在帧间移动或模糊)、色彩漂移(整段片段中色相或饱和度发生变化),以及时间性变形(物体形状在时长内缓慢走样)。
任何将用于专业场景的片段,都要导出帧序列并以 100% 缩放逐帧审查。视频格式的压缩瑕疵,可能会掩盖那些在帧层面才看得见的质量问题。
用相同提示词、不同种子跑三次,把输出相互比较。若各次之间方差很大,说明生成不稳定,每份输出都需要大量人工质检。若方差很小,你就找到了一个可复用的可靠提示词。
05
AI 生成在哪些方面胜过传统动画流程
最明显的优势是风格探索的速度。在三十分钟内为一个动作概念生成十种视觉上迥然不同的诠释——用传统工具需要好几天的工作量——改变了创意开发早期阶段的运作方式。对传统制作的投入,只需为已验证的方向而付出。
抽象与非具象运动,是生成器一贯擅长的领域。运动背景、粒子系统、流体动力学和几何变换,都能稳定产出高质量输出,因为不需要维持任何角色或物体的一致性。
06
当前的硬性局限,以及正在改善的方面
跨场景的角色一致性,仍是最重要的未解难题。除非施加特定的一致性条件,否则在一个场景中生成的角色,到第二个场景里会明显变样。现有方案(参考图、ControlNet 式条件约束)有帮助,但不能彻底解决问题。这严重限制了叙事型动画。
改善最快的是输出分辨率、生成速度和风格控制;改善最慢的是语义理解——模型准确遵循复杂空间与时间指令的能力——以及物理合理性,尤其是刚体动力学。预计未来十二个月分辨率和速度会有显著进展;而角色一致性与物理,恐怕还会在更长时间里停留在部分解决的状态。