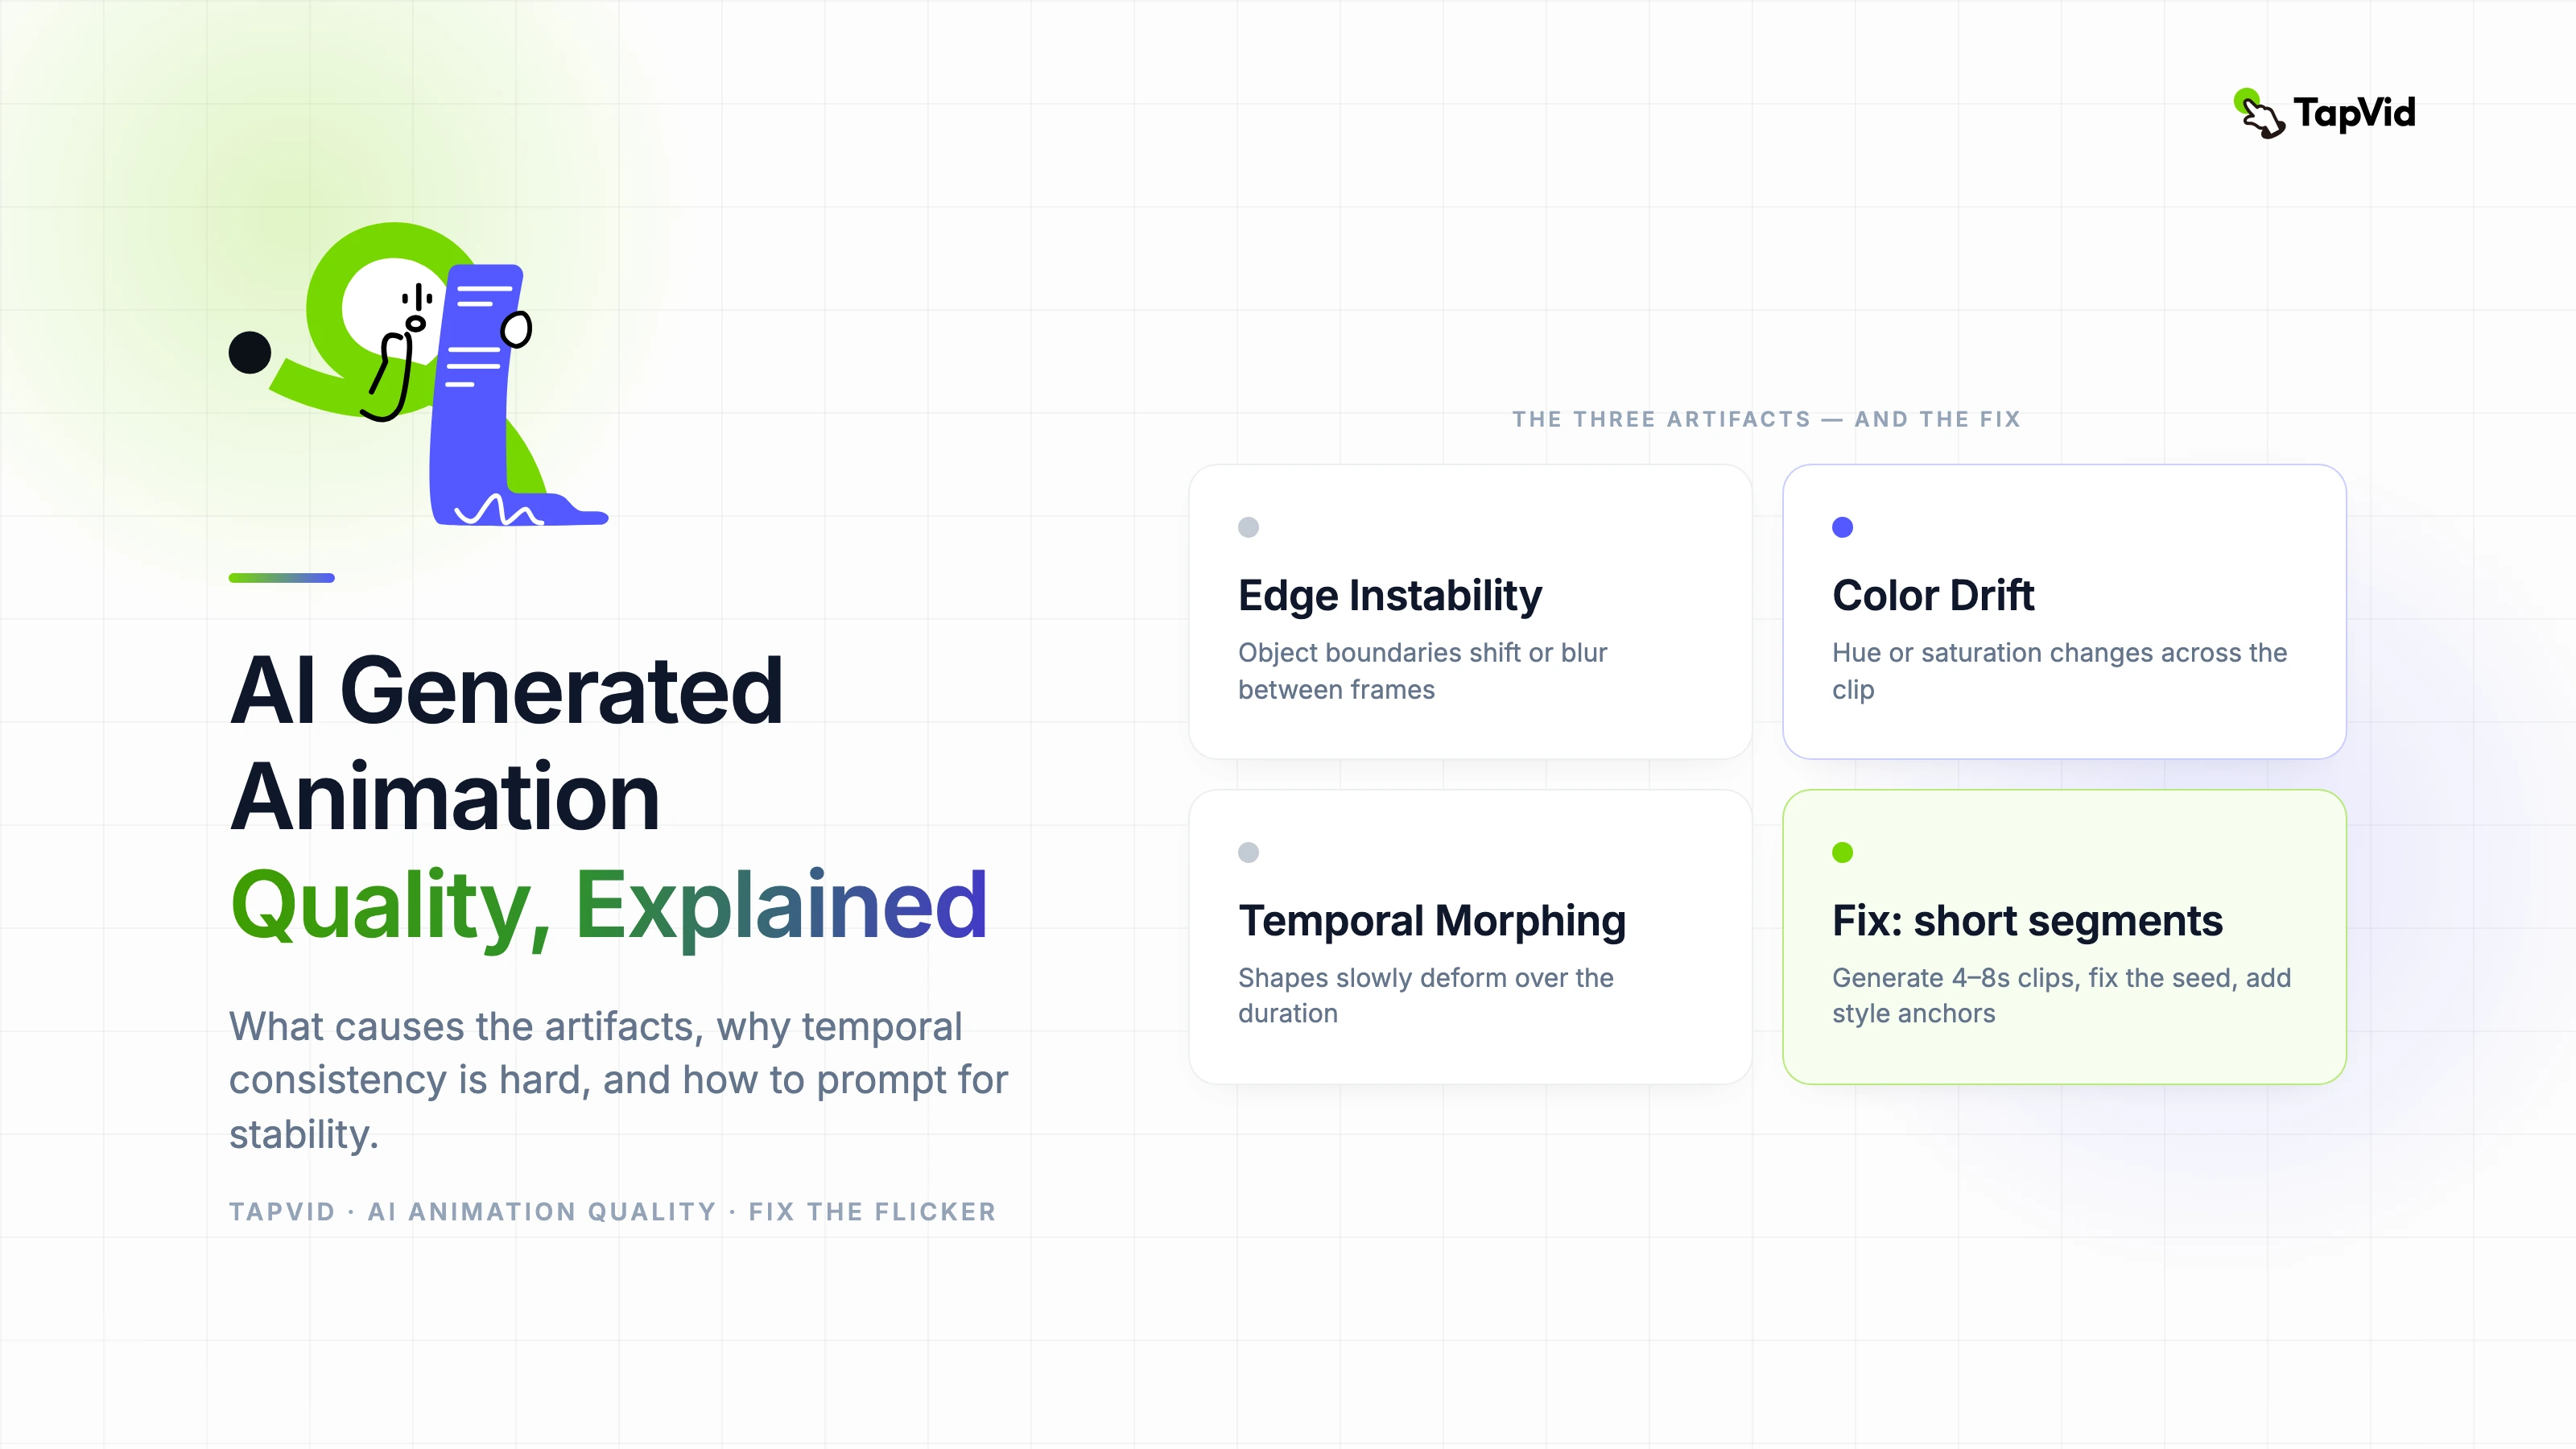

關於 AI 生成動畫,最常見的抱怨是它“看起來很 AI”。人們這麼說時,通常指的是某個具體環節在技術上出了問題——臉在影格之間輕微變形、logo 邊緣閃爍、動作不遵循真實物理。一旦你弄清成因,這些都是可以解決的問題。問題不在於模型不好,而在於“生成”與“一致性”是兩個不同的技術難題,而大多數工具只部分解決了後者。
01
AI 影片生成究竟是如何產生畫面的
目前的影片生成模型大多以擴散(diffusion)為基礎:從雜訊出發,逐步細化,最終得到與條件訊號——你的提示詞、參考圖,或兩者——相符的輸出。這種細化發生在稱為“潛在空間(latent space)”的視覺空間壓縮表示中,而非直接作用於像素值,這也是生成在目前硬體水準下具備可行性的原因之一。
逐格生成與時間(temporal)生成之間的區別,對輸出品質影響極大。逐格模型在帶有少量共享脈絡的情況下獨立生成每一格——速度快,但會產生閃爍,因為每一格都是對同一提示詞略有不同的解。時間模型則顯式地在時間維度上建模運動,輸出更平滑,但所需算力大得多。
面向消費者的大多數工具,會以某種方式組合使用時間注意力機制:既把相鄰影格關聯起來,又在較長序列中允許獨立生成。理解這套架構就能明白,為什麼短片段往往比長片段更一致——時間注意力的視窗是有上限的。
02
時間一致性:為什麼在技術上很難
時間一致性,指物體、紋理與光照在影格之間保持穩定,且符合物理世界的運作方式。當它失效時,人類極容易察覺——我們一輩子都在觀察物理現實——但要在生成模型中強制做到這一點,卻是真正的難題。
核心問題在於:即便以前面的影格作為條件,擴散模型對每個解的生成仍相當獨立。去雜訊路徑上的細微差異,會在像素層面產生視覺上不同的結果,即使語意內容完全相同。這些差異在影格之間不斷累積,表現為閃爍。
模型透過多種機制來因應:強制相鄰影格像素級一致的光流(optical flow)約束、沿時間維度傳播特徵的注意力機制,以及錨定物體該如何運動的顯式運動條件。目前沒有任何模型能在高解析度下同時完美解決這三者。
03
讓輸出更一致的提示詞工程
- 風格錨點:加入具體的視覺風格詞(“賽璐璐動畫”“乾淨向量”“照片級寫實”)——它們能約束生成空間、降低變異
- 負向提示:明確排除常見瑕疵類型(“閃爍”“變形(morphing)”“扭曲邊緣”)——模型會對負向條件作出反應
- 種子控制:在對一個可用結果做迭代時固定生成種子——這能保留產生優質輸出的初始化狀態
- 參考圖:以風格參考圖進行條件約束,得到的色彩與紋理會比純提示詞生成一致得多
- 保持簡短:以 4–8 秒的片段生成以取得最佳一致性——越長的生成累積的時間漂移越多
04
如何系統地評估 AI 動畫輸出
先以 1× 速度逐格檢視一遍輸出,再以 25% 速度看一遍。留意三種最常見的瑕疵:邊緣不穩定(物體邊界在影格間移動或模糊)、色彩漂移(整段片段中色相或飽和度發生變化),以及時間性變形(物體形狀在時長內緩慢走樣)。
任何將用於專業場景的片段,都要匯出影格序列並以 100% 縮放逐格審查。影片格式的壓縮瑕疵,可能會掩蓋那些在影格層面才看得見的品質問題。
用相同提示詞、不同種子跑三次,把輸出相互比較。若各次之間的變異很大,代表生成不穩定,每份輸出都需要大量人工品管。若變異很小,你就找到了一個可重複使用的可靠提示詞。
05
AI 生成在哪些方面勝過傳統動畫流程
最明顯的優勢是風格探索的速度。在三十分鐘內為一個動作概念生成十種視覺上迥然不同的詮釋——用傳統工具需要好幾天的工作量——改變了創意開發早期階段的運作方式。對傳統製作的投入,只需為已驗證的方向而付出。
抽象與非具象運動,是生成器一貫擅長的領域。運動背景、粒子系統、流體動力學與幾何變換,都能穩定產出高品質輸出,因為不需要維持任何角色或物體的一致性。
06
目前的硬性侷限,以及正在改善的方面
跨場景的角色一致性,仍是最重要的未解難題。除非施加特定的一致性條件,否則在一個場景中生成的角色,到第二個場景裡會明顯走樣。現有方案(參考圖、ControlNet 式條件約束)有幫助,但無法徹底解決問題。這嚴重限制了敘事型動畫。
改善最快的是輸出解析度、生成速度與風格控制;改善最慢的是語意理解——模型準確遵循複雜空間與時間指令的能力——以及物理合理性,尤其是剛體動力學。預計未來十二個月解析度與速度會有顯著進展;而角色一致性與物理,恐怕還會在更長時間裡停留在部分解決的狀態。