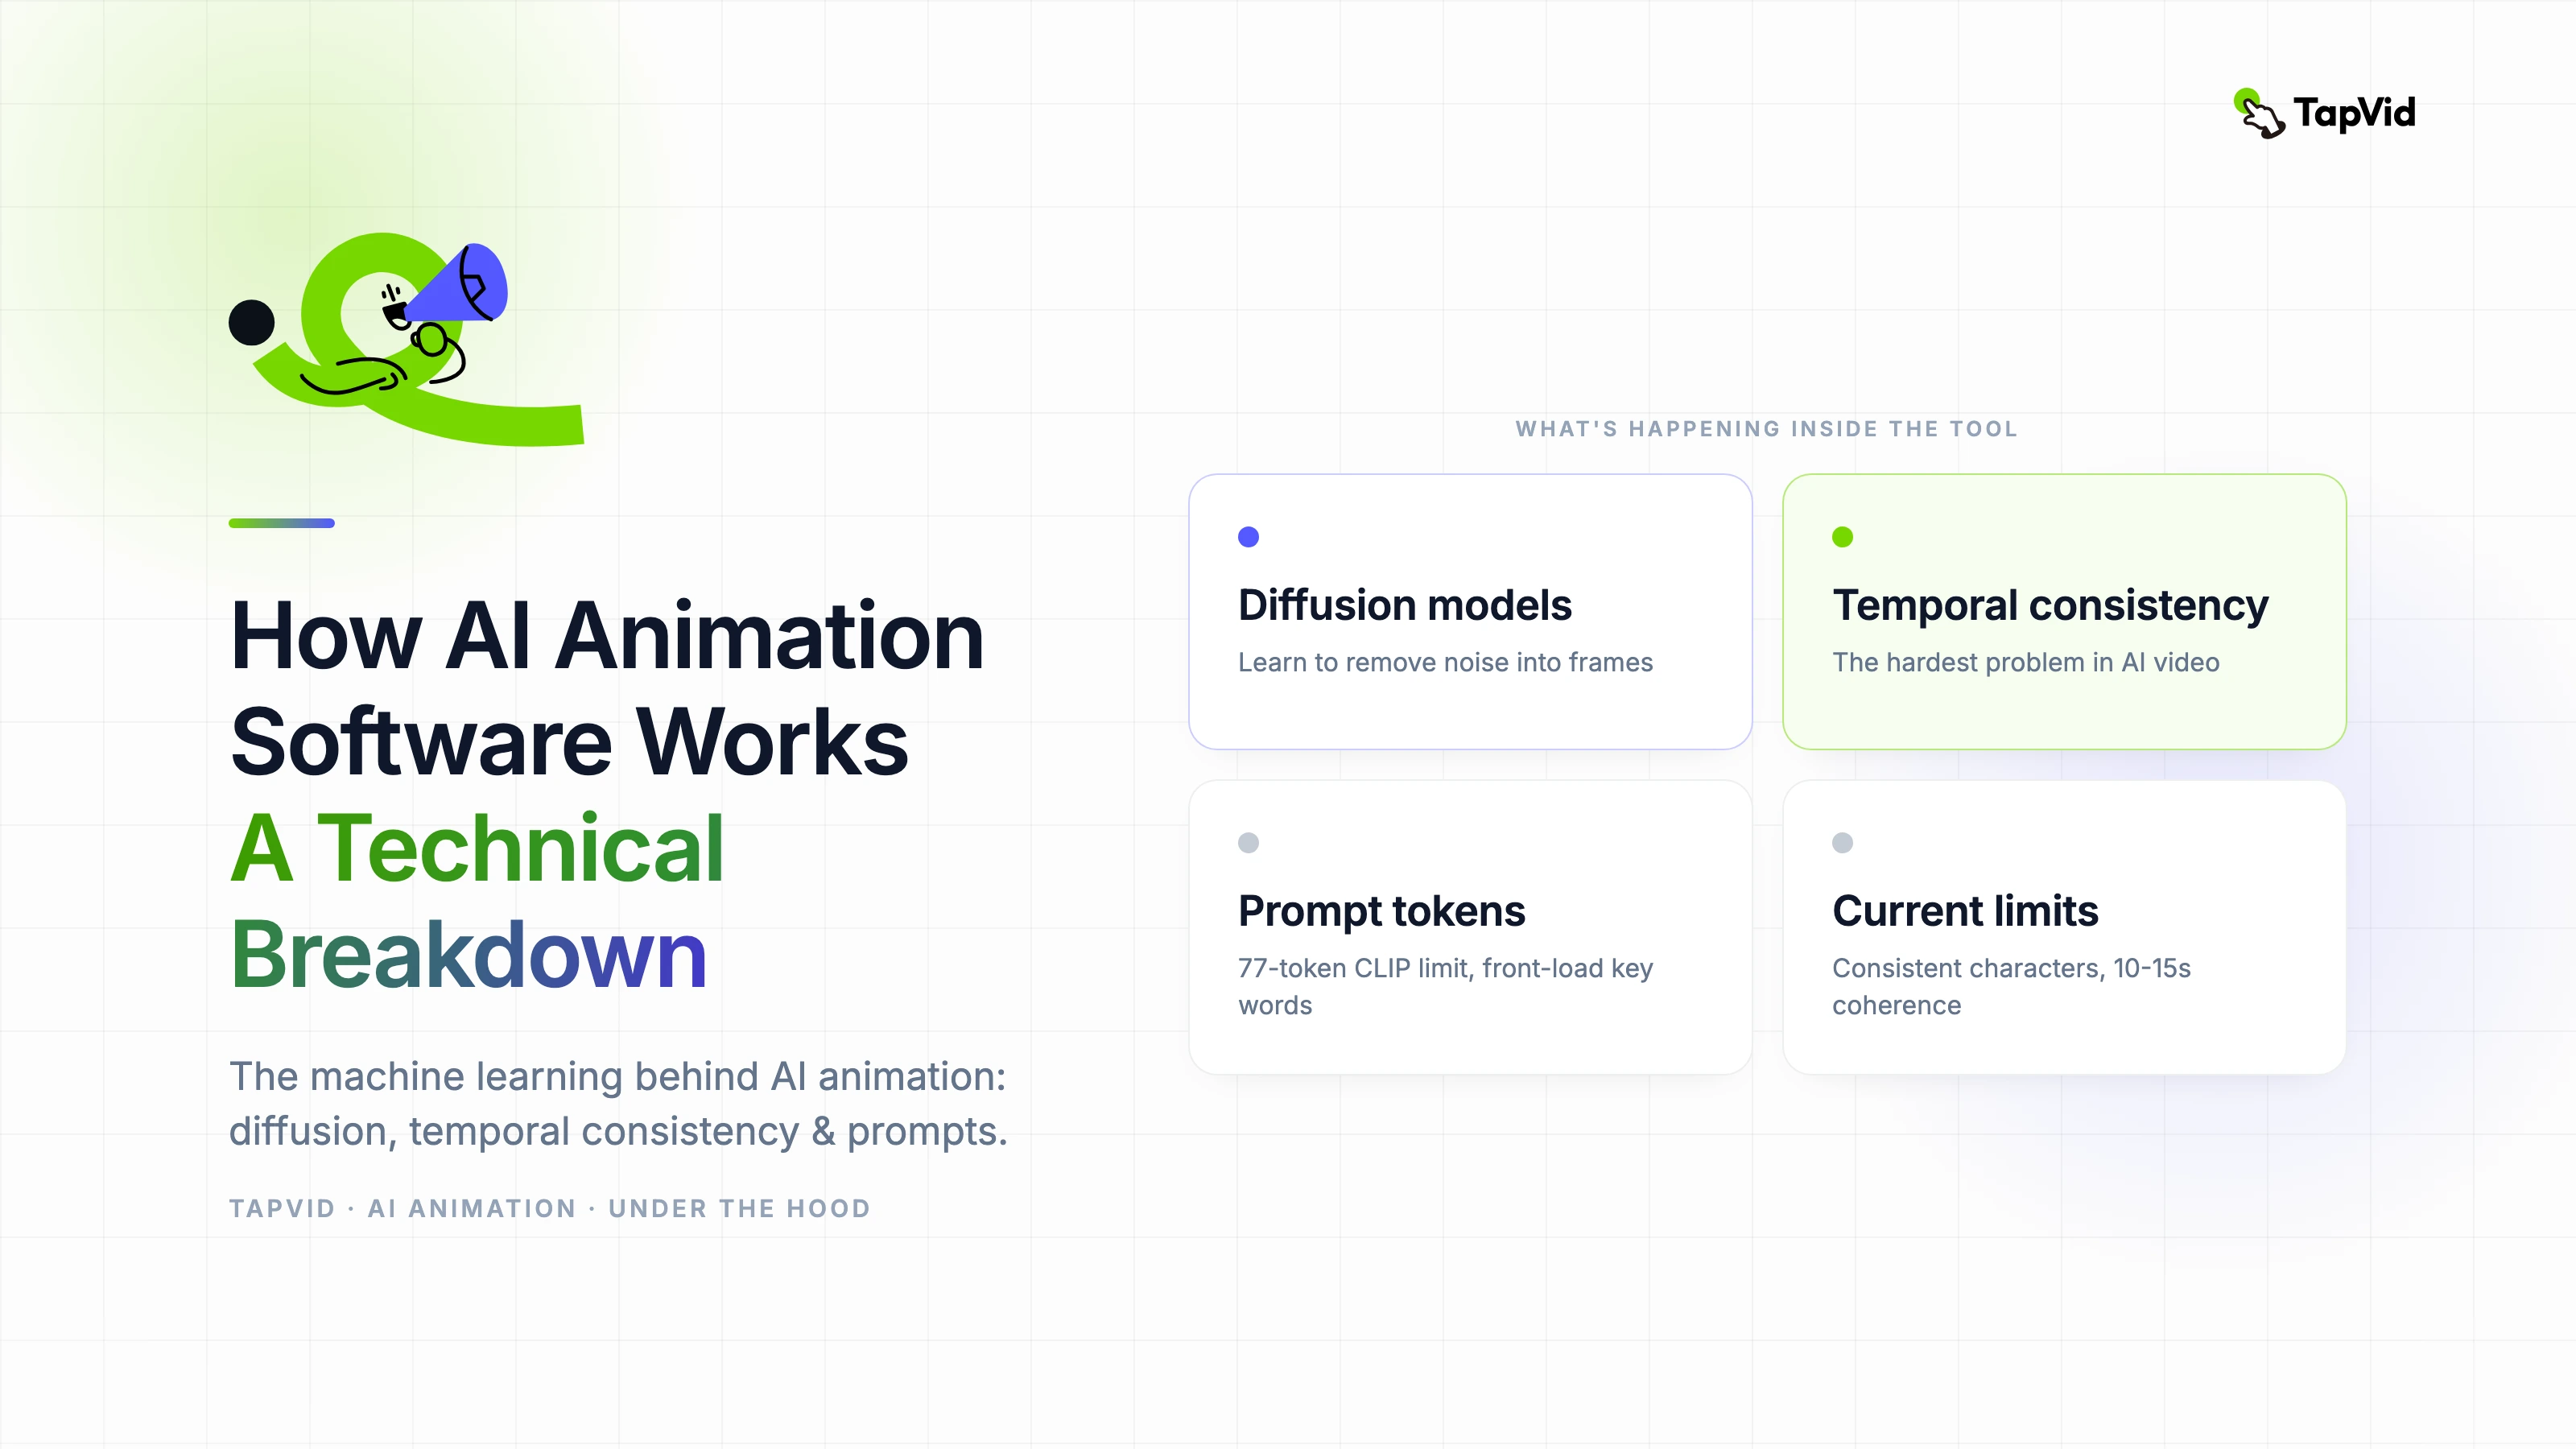

AIアニメーションツールを使う人の多くは、その内部で実際に何が起きているのかを知りません。それでも普段は問題ありませんが、そうもいかない時があります。出力が特定の形で崩れるとき、あるいはどう言い換えても同じアーティファクトが出続けるとき、根底にある仕組みを理解することが、最も早い解決の道になります。これは、こうしたツールをより効果的に使いたい同僚たちに私が伝えている説明です。
01
中核となる仕組み:AIアニメーションソフトが実際に行っていること
AIアニメーションソフトにプロンプトを入力して動画が出力されるまでの間、いくつもの異なる計算処理が順番に実行されています。これらの処理を大まかに理解しておくと、ツールが得意なこと、失敗しやすいところ、そしてより良い結果を生むプロンプトの書き方を予測できるようになります。
現在のAIアニメーションツールの多くは、拡散モデルを基盤に構築されています。拡散モデルは、ノイズを加える処理の逆向きを学習することで画像を生成します。つまり、完全にランダムな信号からノイズを取り除き、一貫した画像を段階的に再構築する方法を学ぶのです。動画生成はこれを拡張し、時間的に一貫したフレーム列、すなわち隣り合うフレームが同じシーンに属して見えるような連続画像を生成します。
時間的一貫性の質――フレーム間の遷移がどれだけ滑らかか――は、現時点でAIアニメーションツールを分ける最大の技術的な差別化要素です。あるツールが滑らかに見えるアニメーションを生む一方で、別のツールがカクつきやモーフィングのアーティファクトを生み、AI動画を不自然に見せてしまう理由がここにあります。
02
拡散モデルはテキストからどう動きを生み出すのか
テキストから動画への生成は、まずテキストエンコーダーがプロンプトを数値表現――高次元空間のベクトル――へ変換するところから始まります。このベクトルが拡散処理を条件づけ、ノイズ除去の過程をプロンプトの意味内容に沿ったフレームへと導きます。
このモデルは、動画クリップと説明文を組み合わせた大規模なデータセットで学習されています。学習の過程で、説明文と視覚パターンとの統計的な結び付きを習得しました。推論時にプロンプトを与えると、モデルはそれらの結び付きを頼りに、もっともらしい動画シーケンスを組み立てます。
だからこそ、プロンプトの具体性は創作面だけでなく技術的にも重要です。具体的なプロンプトは、より狭く一貫した統計的な結び付きを活性化します。曖昧なプロンプトは散漫な結び付きを活性化し、出力はそれらを平均化して、ありきたりな結果になってしまいます。
03
時間的一貫性:AIアニメーション最大の難問
高品質なAI画像を一枚生成することは、すでに解決済みの課題です。しかし、同じシーンのフレームのように見える画像列を――照明、形状、動きの物理を一貫させて――生成することは、はるかに困難です。
技術的なアプローチはモデルのアーキテクチャによって異なります。あるものは明示的なオプティカルフロー推定を用いて、フレーム間でピクセルがどう動けるかを制約します。別のものはアテンション機構を用いて、生成中に各フレームが隣接フレームを参照できるようにします。最新のモデルは3D畳み込みアーキテクチャを使い、空間次元と時間次元を同時に処理します。
実用的な観点では、これはAIアニメーションの出力がアプローチに応じた特有の失敗パターンを持つことを意味します。オプティカルフロー方式は、速い動きがあると歪みのアーティファクトを生じることがあります。アテンション方式は、高周波のディテールでちらつきを生じることがあります。自分のツールがどの方式を使っているかを知っておくと、その固有の弱点を避ける設計がしやすくなります。
04
プロンプトの長さと構造が出力品質を左右する理由
AIアニメーションのためのプロンプトエンジニアリングは、でたらめではありません。テキストエンコーダーが言語を処理する仕組みの具体的な性質に対応しています。動画生成モデルで使われるテキストエンコーダーの多くには最大トークン長があり――CLIP系エンコーダーでは通常77トークン、T5系エンコーダーではより長くなります。
プロンプトがモデルのトークン上限を超えると、後ろの単語は条件づけ信号の中で切り捨てられたり重みを下げられたりします。非常に長いプロンプトが、記述した後半を無視したような結果を生みがちなのはこのためです。実践的には、最も重要な記述語をプロンプトの先頭に置くことをおすすめします。
ネガティブプロンプト――望まないものを指定する手法――は、拡散処理がそこから遠ざかるような条件づけ信号を作り出すことで機能します。特定の歪みの種類など、よくある失敗パターンを避けるには有効ですが、複雑な意味的除外には信頼して使えるものではありません。
05
今のAIアニメーションソフトがまだ苦手なこと
- キャラクターの一貫性:複数の生成クリップにわたって同じキャラクターの見た目を保つことは、明示的な条件づけがなければ、多くのモデルで技術的に未解決のままです。
- 物理の正確さ:流体力学、布のシミュレーション、剛体の衝突は、シミュレーションではなく学習データから近似されます。結果はもっともらしく見えても、物理的に正確ではありません。
- 長尺での一貫性:多くの現行モデルでは、10~15秒を超えるシーケンスで一貫性が崩れていきます。
- 細やかな制御:特定のカメラの動き、正確な空間配置、フレーム単位のタイミングは、テキストプロンプトで指定するのが困難です。
- ブランドカラーの精度:拡散モデルは確率分布からサンプリングします。正確なHexコードでの色一致には明示的な条件づけの仕組みが必要ですが、多くのコンシューマー向けツールはまだそれを備えていません。
06
技術の進む方向:最も速く改善している領域
時間的一貫性は急速に改善しています。2025年後半から2026年初頭に学習されたモデルは、同じプロンプトで2年前のモデルより測定可能なほど滑らかな出力を生みます。この改善は、より優れた時間的アノテーションを備えた大規模な学習データセットと、時間的アテンション層におけるより洗練されたアーキテクチャ上の選択によって支えられています。
キャラクターの一貫性は、いま最も活発に研究投資が行われている領域です。IP-AdapterやControlNetの各種派生といった手法は、フレーム間でキャラクターの見た目を制約する明示的な視覚的条件づけを可能にします。これらの手法のコンシューマー製品への実装は、研究成果からおよそ12~18か月遅れています。
いまAIアニメーションソフトを使うチームにとっての実践的な含意はこうです。今日ぶつかる制約は、今後18~24か月で目に見えて小さくなります。現在のツールの制約に深く最適化しすぎるのではなく、より良いツールが登場したときに取り込めるワークフローを組み立てましょう。